DeepSORT 多目标跟踪:给每一辆车发一个不变的身份编号
检测只回答「这一帧里有车、在哪个框里」。可路口统计要的不是这个,而是「这一辆车从哪来、到哪去」。中间差的是一条跨帧的连线:先按运动猜它跑到哪,再比对外观确认是同一个,最后发一个只增不减的 ID。
01目标:每辆车一个固定编号,交叉时也不会换人
- 说清检测与跟踪的分工:检测给「这一帧有什么」,跟踪给「跨帧的它是谁」,以及为什么后者不能靠框重叠硬扛
- 跑通
python src/app.py --video test.mp4,让每辆车带上黄色ID N car标签,并读得懂终端那行tracks=13 - 调出两种失败:把
max_age调小 → 遮挡几帧就换号;把max_dist调小 → 同一辆车被认成两辆
难点:直觉是「框重叠最多的就是同一辆」,实际是先看长相(余弦距离)、位置只做门限;因为两辆车擦身而过时,重叠度最高的往往不是同一辆。
1280×720 的固定机位视频。也可以换 --ros 的相机画面。
每辆车一个黄框 + 不变的身份编号,终端每 30 帧打印 tracks=13 表示当前有 13 条活跃轨迹。
02问题:检测给了框,可它不知道「这还是刚才那辆」
路口装一台相机,想统计「今天过了多少辆车、每辆往哪走」。你可能想:检测不是已经能框出车了吗,数一数框不就完了?
数不了。检测是「一帧一帧独立看」的:这一帧 3 个框,下一帧还是 3 个框,它说不出哪个框接着哪个框。车往前开 20 像素,对检测来说就是「一辆全新的车」。用框数当日流量,同辆车会被数几十次。
| 对比 | 平时你看到的(黑盒) | 机器必须做的(白盒) |
|---|---|---|
| 画面里有什么 | 车、人、路牌,一眼就分清 | 只有几千个格子里的分数,和几个框 |
| 它是不是刚才那辆 | 你看一眼就认得 | ? —— 没有「记忆」,也没有「长相」的概念 |
| 被挡住几秒又出现 | 你记得它,接着看 | ? —— 中间那几帧没有框,凭什么接上 |
把问号拆成三个具体问题:
① 车在动,框也在动,凭什么把这两个框认成同一辆?
② 两辆车交叉、擦身而过,怎么保证 ID 不互换?
③ 画面里的 ID 会涨到 30 多,这编号是随机的吗?
03现象:同一辆车十几秒后还是 ID 12
你会看到:高速路上每辆车套一个黄框,左上角写 ID 12 car。终端刷 [track] 30帧平均帧率: 16.4 tracks=13。下面三张是在板上真实跑出来的画面(同一段 test.mp4,不同时刻)。
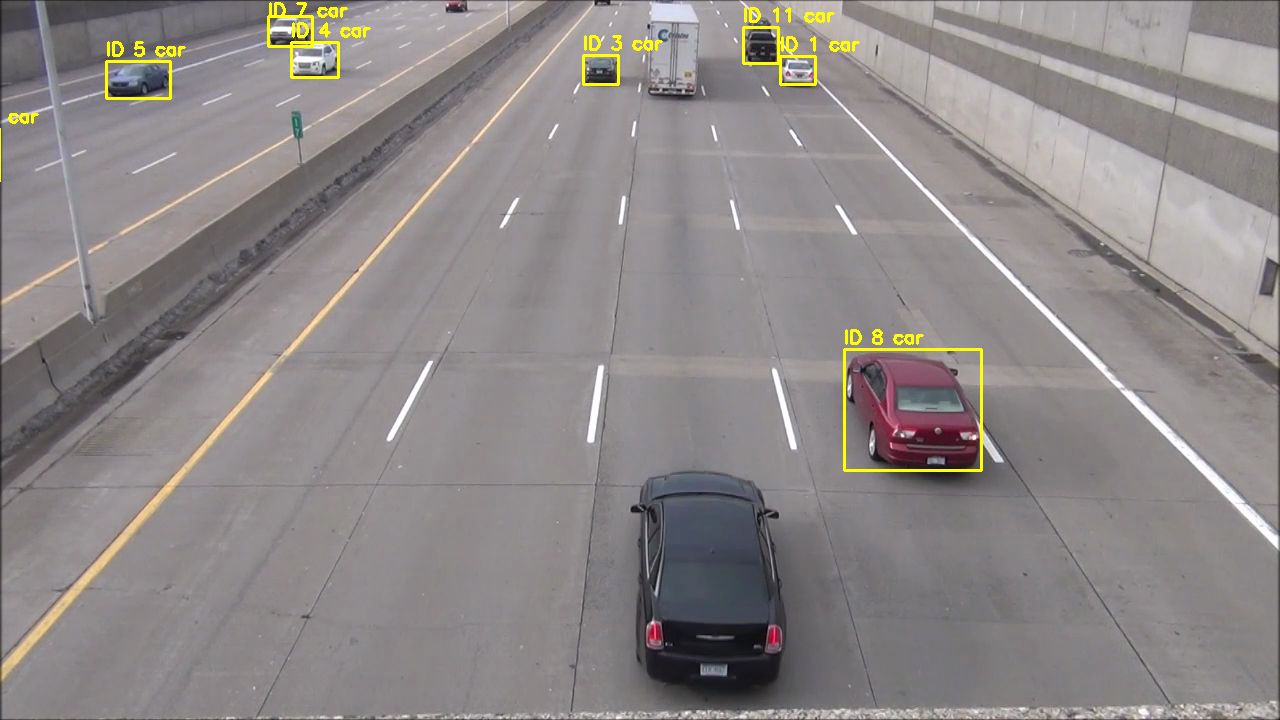
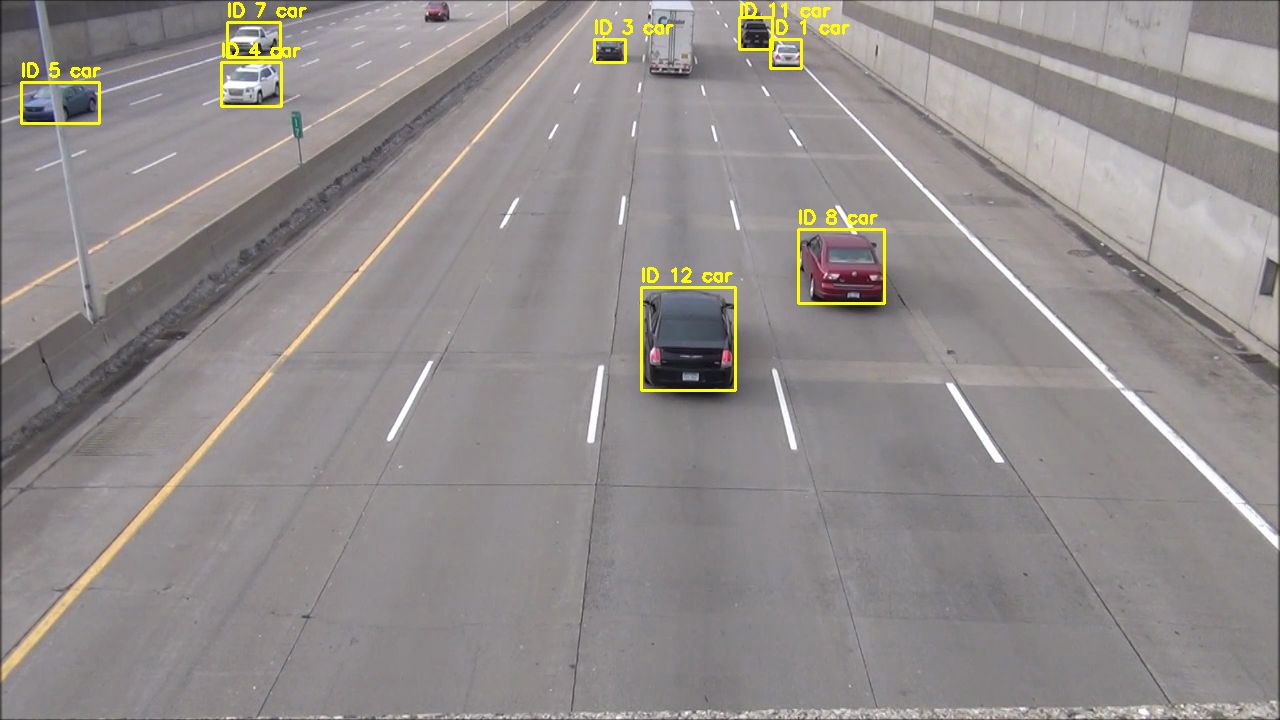
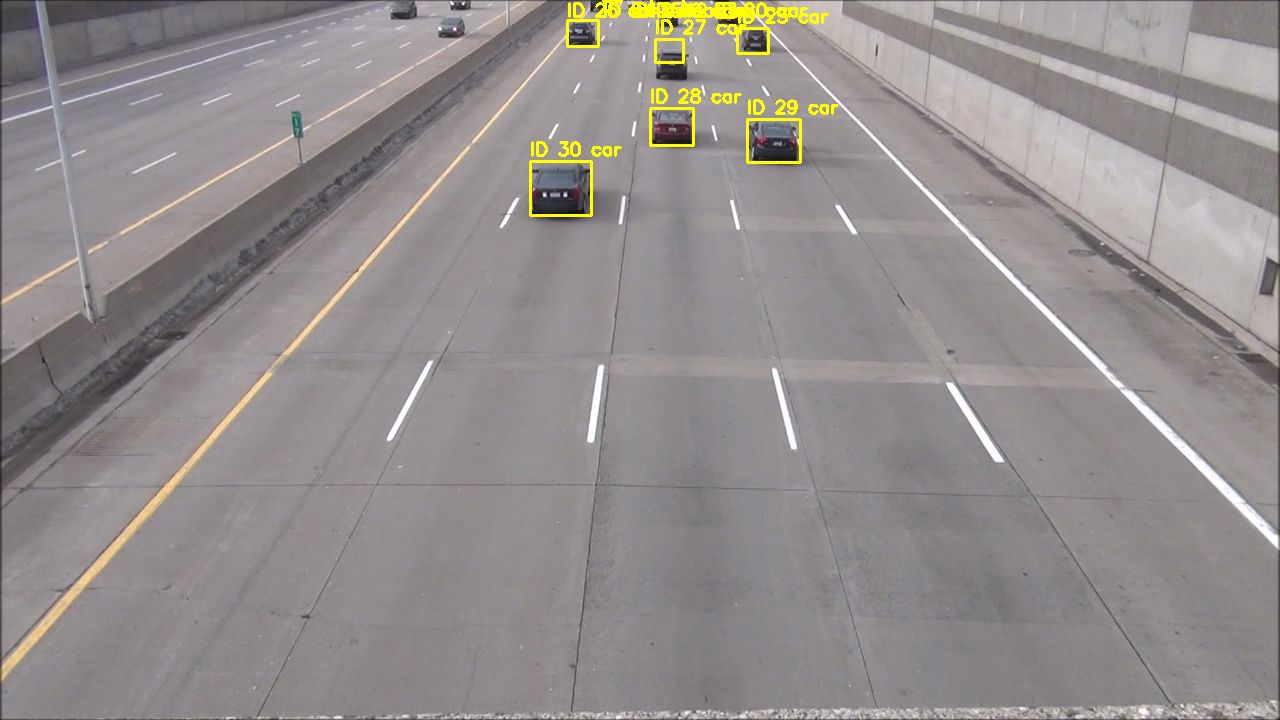
怎么跑出来(两条命令):第一条进目录确认模型与视频,第二条跑视频模式,浏览器打开推流地址看实时结果。
cd ~/ros2_ws/src/xflz_eai_car1/vision/07_multi_object_tracking
ls models/ test.mp4
python src/app.py --video test.mp4
启动时也会刷几行 W RKNN: … not match 与 dynamic range 提示,属静态 shape 模型的正常输出,不影响结果。
🔍 看什么:三件事,看完再看下一节。
- 同一辆车的编号不变 —— 红车从画面这头开到那头,标签一直是同一个数字,不会因为框移动就换号。
- 框会「跟丢后补上」 —— 车被前车挡一下,框闪一下再回来,回来还是原编号。这是卡尔曼预测在撑着。
- 编号只增不减 —— 第 ③ 张编号已经到 30 了,可画面只有 5 辆车。编号是「历史上第几个被确认的目标」,不是「现在第几个」。
这就是本实验最终要呈现的现象。先照做、看懂它;第 05 节会带你亲手复现这三张图,并补上单图与实时两路。
04原理:四步连线题:先猜位置、再看长相、整体配对、发号淘汰
每一帧都在做一道连线题:把上一帧留下的「老轨迹」和这一帧检出的「新框」连起来,连上就沿用旧编号,连不上就发新编号。
打个比方:像在人群里找刚才那个人 —— 先按他走路的速度猜他现在大概在哪(预测),走到那片区域再认脸(外观),脸对上了才算同一个人。揭个盖:人眼是「猜位置 + 认脸」一起完成的,机器必须拆成两步、还给每步定一条数值门限,于是才有了下面这些参数。
四个步骤回答第 02 节的三问:① 凭什么认同一辆 → 步骤 2 与 3;② 交叉不换人 → 步骤 3;③ 编号为什么涨 → 步骤 4。
1这一帧到底有哪些框?
吃什么:一帧图。做什么:跑 yolov8n(9 输出,检测模型,没有掩码分支)。吐什么:若干个框 + 类别 + 分数,再用 min_confidence: 0.6 筛一遍。
这一步与 EXP-06 的步骤 1~3 同款,唯一区别:配置是 classes: [2](COCO 里的 car),所以画面上只出现车,人和巴士都被挡在外面。这也解释了一个常见疑惑:拿一张只有巴士的图去跑,会得到 tracks=0。
动它会怎样:min_confidence 调低(0.3)→ 弱检测也进跟踪,框变小、编号到处乱飘;调高 → 远处的车干脆不参与。
2它跑到哪去了?—— 没检测到也能猜
每条轨迹自带一个卡尔曼滤波器,状态是 8 个数:框中心 cx, cy、宽高比 a、高度 h,再加上它们各自的变化速度。所以轨迹「记得住」这辆车正在往哪开、开多快。
每帧先做一次 predict():不看这一帧有没有检测,先把框按速度往前推一格。这就是第 02 节第一问的一半答案 —— 车被挡住的那一两帧,画面上的框不是「停在上个位置」,而是「按速度推出来的位置」。
为什么用高度 h 做尺度:远处的车小、近处的大,用高度当基准,噪声参数能随框大小自动缩放,近处宽容、远处严格。
动它会怎样:这一步没有可调参数。但预测只对未来几帧有效 —— 推太久(比如丢失 30 帧还按老速度飞)会飞出去,所以必须有步骤 4 的淘汰。
3两个框,凭什么说是同一辆车?
这是第 02 节第一、二问的核心。做法分三层,顺序是关键:
- 先看长相:把每个框裁出来,缩到 64×128、按 ImageNet 归一化,过 ReID 模型得到 512 维向量。两枚向量夹角越小越像,用余弦距离衡量。同时用马氏距离卡一道门:位置离预测太远的配对直接作废(阈值取
CHI2INV95[2],统计上的 95% 置信界)。 - 再按「丢了多久」分级:刚丢 1 帧的先配、丢 2 帧的再配……一直到丢 70 帧,这叫级联匹配。为什么顺序重要?刚丢的轨迹位置预测最准,让它们优先挑,才不会被「丢了很久、已经飘了」的旧轨迹抢走检测。
- 最后兜底:还没配上的、以及还没被确认的新轨迹,用纯 IoU 配一次(
max_iou_distance: 0.8)。
为什么不是「重叠最多的就是同一辆」:两车并行或交叉时,IoU 最高的那一对经常是错的 —— 能区分它们的是长相。所以外观优先、IoU 兜底。
动它会怎样:max_dist(默认 0.2)是长相门限,调小 → 遮挡后回来被当成新车;调大 → 两辆同款同色的车可能被认成一辆。max_iou_distance 调小 → 移动中的车容易丢轨迹(配置注释写明 0.7 会丢,所以取 0.8)。
4编号为什么能涨到 30 多?
这是第 02 节第三问的答案,也是画面上最容易让人误解的一个数。
- 连上了:轨迹继承旧编号,只更新位置与外观特征库(
nn_budget: 100条,超了丢最旧的)。 - 没连上:这个检测新建一条轨迹,编号 =
_next_id,然后计数器 +1。计数器从 1 开始、永不回退。 - 新轨迹要先「试用」:连续命中
n_init: 3帧才被确认、才会画出来。闪过一帧的误检不占编号。 - 淘汰:连续
max_age: 70帧没配上就删除轨迹。注意删除不回收编号。
动它会怎样:max_age 调小(10)→ 遮挡几帧就换号,编号涨得飞快;调大(200)→ 抗遮挡更强,但开走的车轨迹会在画面外飘很久,容易被别的检测接上变成错号。n_init 调大 → 编号更干净,但新目标要慢几帧才显示。
先认识 5 个词
一条「跨帧的目标」,自带编号、卡尔曼状态、外观特征库。什么时候失效:连续 max_age 帧没配上就被删除。
按目标当前速度推算下一帧大概在哪。什么时候失效:急停急转时预测会偏,靠步骤 3 的外观拉回来。
按「丢了多久」分轮配对,刚丢的先挑。什么时候失效:密集场景里同款车多,长相也会撞车。
两枚 512 维外观向量的夹角,越小越像,范围 0~2。什么时候失效:逆光、夜间低对比的目标,特征会失真。
专门把「一个目标」压成向量的模型,与检测模型不是同一个文件(deepsort.rknn)。什么时候失效:缺失时自动退回 sort 纯 IoU 模式并告警。
什么时候会翻车:五个真实边界选读 1 分钟
- 密集同款车 —— 一排白色轿车排队通过,长相几乎一样,外观也会指错。此时只能靠位置与速度,需要适度收紧
max_iou_distance。 - 长时间遮挡 —— 超过
max_age帧还没重现,轨迹被删,回来一定是新编号。这不是 bug,是「愿意等多久」的取舍。 - 出画面再进来 —— 同一辆车从左边出去、右边进来,中间完全消失过,就只有新编号。跨镜头还需要专门的 ReID 检索,不在本实验范围。
- 相机自身在动 —— 卡尔曼假设背景静止。相机一晃,所有预测都偏,配对大面积失败。
- ReID 缺失 —— 会打印
[warn] ReID load failed …; falling back to SORT,退化成纯 IoU:交叉换人、遮挡换号都会出现。
| 步 | 数据变成什么 | 为什么非它不可 / 少了会怎样 | 谁在干 | 动参数会怎样 |
|---|---|---|---|---|
| 1 | 一帧图 → N 个框(类 + 分数) | 框都没有,跟踪无从谈起 | detect.decode | score_thr↑ 漏检;classes 决定追谁 |
| 2 | 每条轨迹 → 1 个预测框(8 维状态) | 不做预测,遮挡 1 帧就断线 | Tracker.predict | 无参数(噪声固定) |
| 3 | 预测框 × 检测框 → 配对表(外观 + IoU 两道) | 只按重叠配,交叉时必换人 | _cascade / _iou_match | max_dist↓ 换号、↑ 认错车;max_iou_distance↓ 丢轨迹 |
| 4 | 配对表 → 带 ID 的轨迹集合(新增 / 更新 / 删除) | 不发号就没有跨帧身份;不淘汰会无限增长 | Track / _next_id | max_age↓ 易换号;n_init↑ 显示更慢但更干净 |
这张表只看第 2、5 两列就够用:第 2 列是数据形态,第 5 列是你能拧的旋钮。函数名在第四列,追代码时再看。
05实操:单图 / 视频 / 实时三条命令
先看「敲的命令」和「原理第几步」怎么对上号 —— 每一行都是第 04 节某一格的落地。
| 环节 | 函数(文件) | 吃哪个参数 | 对应原理第几步 |
|---|---|---|---|
| 取流 | cv2.VideoCapture / Ros2Camera.read(app.py / ros2_source.py) | --video --ros | 链外 |
| 检测 | detect.decode(detect.py) | detect.score_thr detect.classes | 步骤 1 |
| 外观特征 | ReIDBackend.__call__(reid.py)→ 512 维 | model.reid_rknn | 步骤 3 |
| 预测与配对 | Tracker.update / _cascade(tracker.py) | tracker.* 六个阈值 | 步骤 2、3 |
| 发号与绘制 | Track 生命周期 + draw_tracks(app.py) | n_init max_age | 步骤 4 |
| 推流 | MjpegServer.set_frame(mjpeg_server.py) | server.port stream_name | 链外 |
-
先用单图确认「只追车」约 3 分钟
单图模式只跑一帧、只起 1 个 worker。因为
classes: [2]只保留 car,拿一张只有巴士和行人的图去跑,会得到tracks=0—— 不是坏了,是过滤生效了。cd ~/ros2_ws/src/xflz_eai_car1/vision/07_multi_object_tracking python src/app.py --image ../06_semantic_segmentation/images/bus.jpg --save out.jpg
[track] mode=deepsort [track] tracks=0 saved -> out.jpg把
classes改成[5](bus)再跑一次,tracks就变成 1。这一步确认:过滤发生在检测之后、跟踪之前。 -
视频模式:看编号稳住约 5 分钟
视频模式起 3 个 worker 的检测池,并把结果推到 MJPEG。
python src/app.py --video test.mp4
[track] mode=deepsort [track] 30帧平均帧率: 14.7 tracks=15 [track] 30帧平均帧率: 16.4 tracks=13 ← 浏览器打开 http://<板IP>:8080/track.mjpg盯近处那辆车的标签:它从画面底部开到顶部,编号一直不变。
tracks会上下浮动,那是同时存在的车辆数在变。 -
实时相机:deepsort 与 sort 对照约 8 分钟
板上标准走法是 ROS 话题。先起驱动再跑程序,两个终端
ROS_DOMAIN_ID必须一致(N 取 0~101 任一整数,每台设备各选各的)。终端一 · 起相机驱动
source /opt/ros/humble/setup.bash && source ~/ros2_ws/install/setup.bash
export ROS_DOMAIN_ID=N
ros2 launch ascamera hp60c.launch.py
日志持续滚动,无 ERROR终端二 · 跑跟踪
source /opt/ros/humble/setup.bash && source ~/ros2_ws/install/setup.bash
export ROS_DOMAIN_ID=N
cd ~/ros2_ws/src/xflz_eai_car1/vision/07_multi_object_tracking
python src/app.py --ros
[track] mode=deepsort [track] 30帧平均帧率: xx.x tracks=N ← http://<板IP>:8080/track.mjpg对照实验:把
tracker.mode改sort重跑(不动模型),再让人从别人身后穿过 ——sort会在交叉处换号,deepsort不会。这就是「长相」那一层的价值。
ID N car、编号沿用不跳、编号只增不减。两处对上了,说明取流、检测、外观、配对、发号五段已完整走通。你该看到的画面
同一辆车穿过画面,标签一直是同一个数字;框偶尔闪一下(预测补位),编号不变。
两车擦身过后编号互换,说明外观那一层被关掉了。
max_age 太小或 max_dist 太小:轨迹一丢就删,回来就是新号。
先看 classes:[2] 只追 car。再看 min_confidence 是否太高。
踩坑速查
| 现象 | 原因 | 怎么办 |
|---|---|---|
| 画面里一个框都没有 | classes: [2] 只追 car,而画面里没有轿车 | 改成要追的 COCO 编号,或写 [] 追全部 |
| 编号每隔几帧就变 | 轨迹被过早删除,或长相门限太严 | max_age 调大(70 → 90),max_dist 放宽到 0.3 |
| 两辆车共用一个编号 | 外观门限太松,两辆同款车被判成同一辆 | max_dist 收紧到 0.15;确认 deepsort.rknn 已加载 |
启动打印 falling back to SORT | ReID 模型缺失或加载失败 | 确认 models/deepsort.rknn 存在;出现这条告警时交叉必换号 |
| 帧率只有个位数 | 只开了 1 个 worker,或 ReID 拖慢 | pool.workers: 3;core_mask 可试 round_robin |
--ros 报 cannot open ros topic | 驱动没起、两终端 ROS_DOMAIN_ID 不一致,或话题被 remap | 先起 ascamera;两边 export 同一个 N;话题保持原生名 |
提示 python: command not found | 没激活板上的 venv | source ~/ros2_venv/bin/activate |
进阶 1 · 在画面里画出运动轨迹约 20 分钟
给每条轨迹存最近 30 个中心点,用 cv2.polylines 连成一条尾巴 —— 一眼看出「谁在往哪走」,也是流向统计的最简版本。
观察点:max_age 调大时,尾巴会在目标消失后继续往前画,这正是「预测还在推进」的可见证据。
进阶 2 · 数一数「过线车数」约 25 分钟
在画面中间画一条虚拟线,某条轨迹的中心点从一侧跨到另一侧时计数 +1(比较上一帧与这一帧的 y 符号)。这是卡口计数、门店客流的基本功。
必须用轨迹 ID 去重,不能按框数累加 —— 否则同一辆车被数几十次,正是第 02 节开头那个坑。
🧪 Vibe Coding · 自己把这段代码读明白约 20 分钟
你要产出三样:模块职责表 → 控制流流程图 → 时序图。提示词给全了,产出后与真源码逐条对照。
提示词 1 · 模块职责分析
请阅读这个多目标跟踪项目的七个模块:src/app.py、src/detect.py、src/preprocess.py、src/tracker.py、src/track.py、src/reid.py、src/rknnpool.py。
它们共同完成「读一帧 → 检测 → 匹配 → 画编号」。
请输出一张表,每行一个模块,四列:模块名 / 一句话职责 / 被谁调用 / 从哪个配置项取值。
要求指出关键函数的所在行号;说不清谁调谁的地方请标出来,不要猜。
提示词 2 · 控制流流程图
请按「主线程处理一帧」的视角,为 src/app.py 的主循环画一张流程图。
必须包含:检测池 put/get 的进出;tracker.predict 与 tracker.update 的先后;没有检测结果时如何处理;ReID 缺失时如何退回 sort 模式。
每个框写函数名,判断框写条件,不要用「处理」「分析」这类空词。
提示词 3 · 时序图
请为视频模式画一张时序图,参与者用真实名字:主线程、RKNNPool 的 worker 线程、ReIDPool 的 worker 线程、MjpegServer。
按顺序标出:读帧、检测入队、worker 推理、结果出队、裁剪目标送 ReID、Tracker.update、绘制、推流。
并标注哪些环节是并行流水线,哪些是同步等待。
自查三问:每个模块都能指到真实文件与行号?流程图里有「无检测」和「ReID 失败」两条分支?时序图里并行与串行分得清?
三处必然的差异(对答案用):
| 差异点 | AI 版常见写法 | 工程版(本仓) | 为什么工程这么写 |
|---|---|---|---|
| 匹配顺序 | 对全部轨迹和全部检测算一次 IoU,取最大 | 先按外观级联(丢得少的先配),再用 IoU 兜底(tracker.py:81-89) | IoU 在交叉、并行时会把两辆车配错;外观才是同一目标的判据 |
| 遮挡怎么续 | 没检测到就把框留着不动,或直接丢掉 | 每帧先 predict() 按速度推进,超 max_age 才删(tracker.py:103-105) | 静止保留会「卡住」,直接丢会断号;预测让框跟着车速走 |
| ReID 怎么调 | 在主循环里同步调用一次模型 | 独立 ReIDPool 2 worker × 每线程独立 RKNN 实例,按提交序号回收保序 | NPU 上下文不能跨线程共享;外观推理必须与检测并行,否则帧率掉一半 |
改一处、先预测再验证:把 tracker.max_dist 从 0.2 改成 0.05,先写下你认为画面会发生什么,再跑一次对答案。
06互动:拖 max_age 和 max_dist,看遮挡后还是不是原 ID
📌 这一节是「掌握检查」:亲手改一个参数,看现象是否朝你预期的方向变,还要能说出为什么 —— 说得出,才算掌握。
第 04 节讲了四步,真正的判据只有两条线:「愿意等多久」= max_age,「像不像」= max_dist。命令跑一次只能看一种组合,这里做成能拖的时间轴。
怎么读出规律:先把 max_dist 拉到最大、只动 max_age —— 看到「等多久」这条线;再把 max_age 拉到最大、只动 max_dist —— 看到「像不像」这条线。任何一条断了,编号都会断。
8 ≤ 70,且漂移 0.156 ≤ 0.20,恢复 ID 7。
8 > 5,还没重现轨迹就没了,只能是新号。这就是「遮挡即换号」。
位置在、轨迹也在,但长相过不了门限,照样判成新目标。
漂移涨到 0.42,超过默认 0.20 —— 现实中「挡太久」本来就会换号。
max_age 管时间,max_dist 管长相,两条都要过。07验证:三道小测
回页首对照「实验目标」:① 检测与跟踪的分工讲得清吗 → 试 Q1;② --video 跑通、tracks=13 能否解释 → 回第 05 节自查;③ 两种失败调出来了没有 → 试 Q2 与 Q3,并回第 06 节把两条滑杆各推到极端看一眼。三条全 ✓,这一课就完成了。
sort 模式的表现。工程版先按长相配对,再用 IoU 兜底,所以交叉不换人。第一个选项是常见误解:卡尔曼只是「猜大概在哪」,车急停急转时预测就会偏。detect.score_thr 调到 0.9tracker.max_age 调大(或把 max_dist 放宽),让轨迹不要被过早删掉 / 判生pool.workers 改成 1max_age 太小),或外观过不了门限被当成新目标(max_dist 太小)。调 score_thr 只会让检测更少、编号更乱;workers 只影响帧率。_next_id 每出现一个「配不上的检测」就 +1,删除轨迹时不回收号码。所以编号大只表示「历史上确认过很多目标」,与当前画面里有几辆车无关。要数当前车辆数,看终端那个 tracks=。08章节总结:检测管「在哪」,跟踪管「还是谁」
这页讲了什么,它们怎么串起来
| 概念 | 它解决了什么 | 和别的关系 |
|---|---|---|
| 检测(9 输出) | 把每一帧的「有什么、在哪」找出来 | 上游吃画面,下游是跟踪唯一的输入;classes 在这里就决定追谁 |
| 卡尔曼预测 | 没检测到时也能给出「它大概在哪」 | 补上检测的空档;推得太久会飞,靠 max_age 收尾 |
| ReID + 余弦距离 | 给「是不是同一个目标」一个可比较的数值 | 配对的主依据;模型缺失就退回纯 IoU |
| 级联匹配 | 让刚丢的轨迹优先挑检测,避免被旧轨迹抢走 | 把外观与 IoU 两层串起来;门限 max_dist / max_iou_distance |
n_init / max_age | 一个管「什么时候才算真目标」,一个管「什么时候算走了」 | 共同决定编号的干净与稳定,也就是第 06 节那两条线 |
编号 track_id | 给跨帧目标一个唯一身份,才能统计与计数 | 只增不减;与「当前有几辆车」无关 |
| 推理池 | 把检测与外观推理并行起来抢帧率 | 横向于整条链:只影响 FPS,不影响编号质量 |
② 直觉是编号就是「画面里第几辆车」,实际是历史计数器,只增不减,删轨迹也不回收;
③ 直觉是跟踪比检测贵很多,实际是跟踪整套(预测 + 配对 + 绘制)只占几毫秒,瓶颈仍在检测那约 60ms。
max_iou_distance 用 0.8 不是 0.7:配置注释写明 0.7 时移动目标易丢轨迹,这是踩过的坑;②
max_age: 70 是帧不是秒 —— 16 FPS 下约 4.4 秒,换成 30 FPS 只剩 2.3 秒,改帧率时这个值要跟着改;③ ReID 输出是 512 维(
[1,3,128,64] → [1,512]),不是老文档里的 128 维;④ 单图模式只起 1 个 worker,别拿单图去测帧率。
前置依赖 · 缺一样就跑不起来
| 类型 | 具体项 | 缺了会怎样 / 怎么补 |
|---|---|---|
| 环境 | ROS 2 Humble 两级 source + 相机节点(仅 --ros 需要);板上 Python 在 ~/ros2_venv | --ros 起不来会打印 cannot open ros topic;未激活 venv 则 python: command not found |
| Python 库 | numpy、opencv-python、pyyaml、scipy(匈牙利匹配)、rknnlite、mjpeg_streamer | 缺 scipy 无法做代价矩阵配对;缺 mjpeg_streamer 启动即退出 |
| 模型 / 资源 | models/yolov8n.rknn(检测,9 输出)+ models/deepsort.rknn(ReID)+ test.mp4 | 缺 ReID → 打印 falling back to SORT,交叉换号;缺视频就没有第 03 节那三张图 |
| 配置 | config/track_config.yaml:classes: [2]、mode: deepsort、max_age: 70、n_init: 3、max_dist: 0.2、min_confidence: 0.6 | 缺 key 时 load_config 抛 ConfigError;mode 拼错直接报错 |
| 硬件 / 前置实验 | RK3576 板(3 核 NPU)+ EXP-04 检测基础 + EXP-06 的掩码/后处理概念 | 单核开 3 worker 不会更快;不懂 DFL/NMS 就看不懂步骤 1 的 9 输出 |
这套代码用在哪儿
- 路口卡口计数:虚拟线 + 轨迹跨越判定,按 ID 去重统计车流量与方向,替代地感线圈。
- 门店 / 电梯客流:同一个人被反复计数的问题,靠跟踪 ID 天然解决;配
classes: [0]只追 person。 - 机器人跟人:锁住「要跟的那个人」的 ID,输出它的框中心作为跟随目标 —— 这是 EXP-11 的上游能力。
- 不该用它的场合:只需要「这一帧有没有人」时不必上跟踪,多花的算力没有收益;相机在动、镜头切换的场景也不适用。
max_age 决定敢等多久,max_dist 决定敢认多像 —— 两条线都过,编号才不断。下一个实验换一个方向:跟踪告诉我们「它一直在」,但说不出它离我多远。EXP-10 会用深度图把这个距离补上。