语义分割背景替换:不只框住人,还要把人的轮廓抠出来
视频会议里的虚拟背景,不是给人套一个方框,而是逐个像素判断「这一点算不算人」。这个实验把它跑通:把画面里的人抠出来,背景换成黑色、纯色,或一张风景图 —— 而终端会打印一个和画面对不上的数字,第 02 节就从那个数字问起。
01目标:终端报 4 个实例,画面只留 3 个人
- 说清「检测给一个框、分割给一张逐像素掩码」的差别,并解释终端报 4 个实例、画面却只留 3 个人的原因
- 用
python src/app.py --image ... --save out.jpg跑通「抠图 → 换背景」,并用black模式看清边缘那一圈旧背景的暗边 - 调出预期效果:把
model.classes、model.mask_thr、background.mode各改一次,说清画面哪一处跟着变
mc@proto 怎么把 32 个数变成一张掩码。难点:直觉是「报了几个就该留下几个」,实际是检出(模型干的)和保留(
classes 干的)是两件事;
以及 mask_thr 不是「精度旋钮」,它是「宁缺 / 宁滥」的一条取舍线 —— 调到 0.7 能让边缘干净,也能让手指消失。
810×1080 的街景:三名行人 + 一辆蓝色巴士。也可以换成 --ros 的相机画面。
终端两行 + 一张 out.jpg:三名行人贴着轮廓留下,巴士和整条街道一起变黑。
02问题:虚拟背景不是套框,可为什么报了 4 个只留 3 个
你天天在用的东西:线上会议点一下「背景虚化」,人就还在,身后那面墙变成了另一个房间。你只看到结果,中间发生了什么完全看不见 —— 这就是黑盒。
本实验要打开这个黑盒。第一次跑完,终端会出现这么两行(下一节完整演示):
[seg] 4 instances
saved -> out.jpg
数字是 4,画面里是 3 个人,还有一整辆巴士凭空消失了。这个对不上的落差,就是这一节要问的三个问题。
把黑盒拆成两栏,左边是你看到的,右边是机器必须完成的:
| 对比 | 平时应用(黑盒,你只看到结果) | 内部原理(打开黑盒,机器要做的) |
|---|---|---|
| 怎么换背景 | 人还在、背景变了,中间一步都看不见 | ? —— 需要一张和画面同样大的黑白图,白的地方留原图、黑的地方贴新背景 |
| 画面里有几个东西 | 程序从不说自己「看见了几个」 | ? —— 模型一次给出 4 个实例:3 个 person + 1 个 bus |
| 为什么只留 3 个 | 你根本看不出「谁被丢掉了」 | ? —— 有一处地方按 COCO 编号做了筛选:0 是 person,5 是 bus |
这三个问号,拆成三个具体的问题:
① 每个像素归谁。框只有四个数,掩码有几十万个格子。机器凭什么说出「这一根头发是人、紧挨着的那块墙不是」?
② 报了 4 个,为什么只剩 3 个。终端明明写 [seg] 4 instances,out.jpg 里整辆巴士却一起黑了 —— 是谁把第 4 个丢掉的?
③ 边缘那圈暗边是哪来的。换成纯色或风景背景后,每个人轮廓外都挂着一圈旧背景的残影。是模型不干净,还是有个参数在替你取舍?
所以先看它跑出来什么样 —— 四张真图一次摆齐。
03现象:人贴着轮廓留下,巴士和街道一起变黑
你会看到:原图里三名行人站在一辆蓝色巴士前面;跑完之后,三名行人被贴着轮廓留下来,巴士和整条街道一起变黑。换 image 模式,人就被贴到了另一张照片里。终端只有两行要紧的:[seg] 4 instances 和 saved -> out.jpg。
四张真图,一条链走完(先照做,每步为什么下一节拆讲):
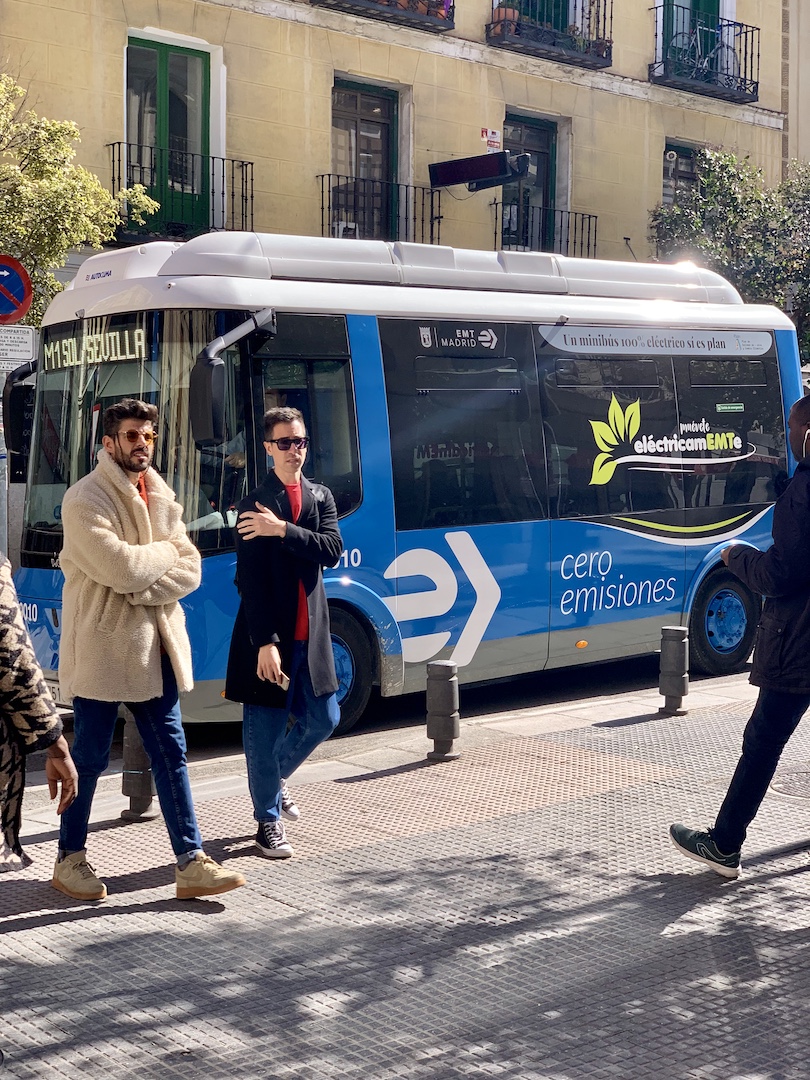
images/bus.jpg(810×1080):人和巴士都在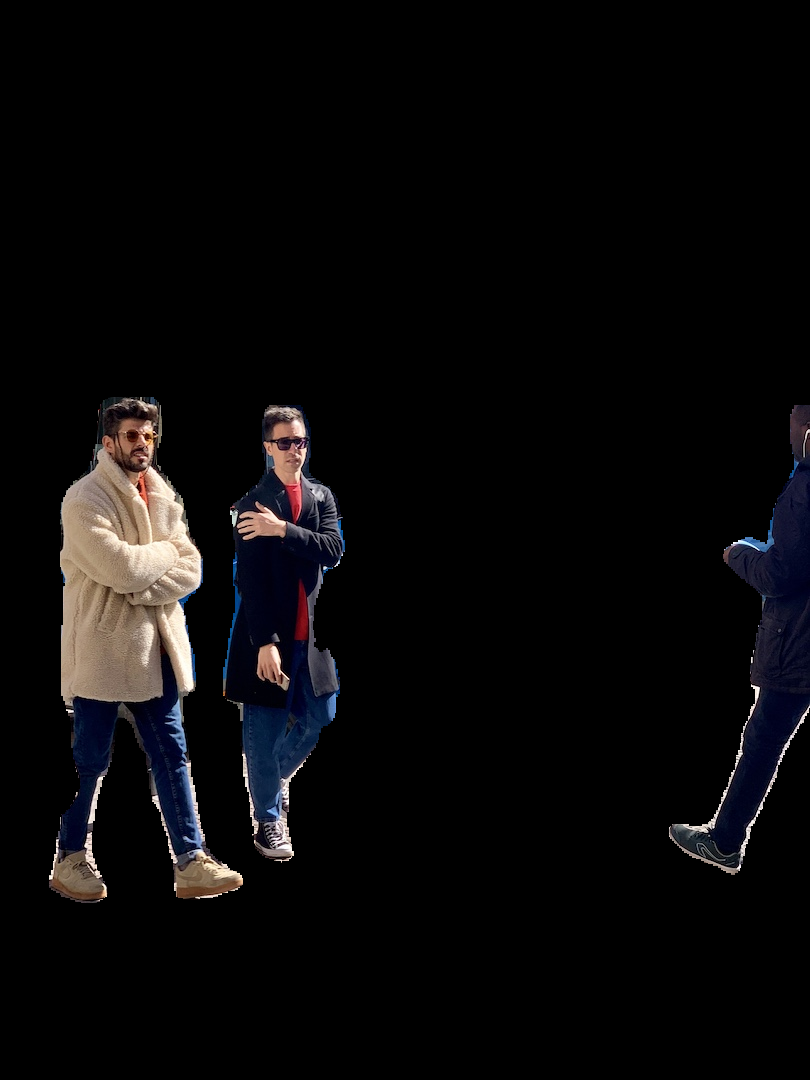
mode: black:人留下,巴士整辆没了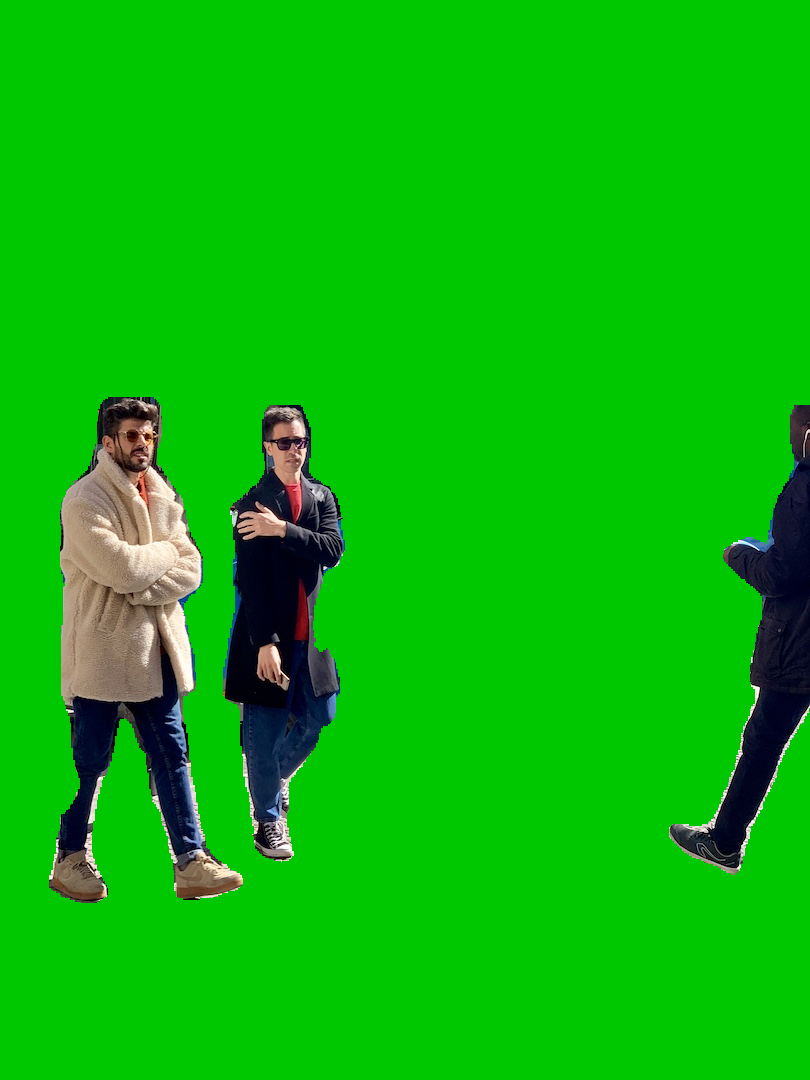
mode: solid + color: [0,200,0]:轮廓外那圈暗边一目了然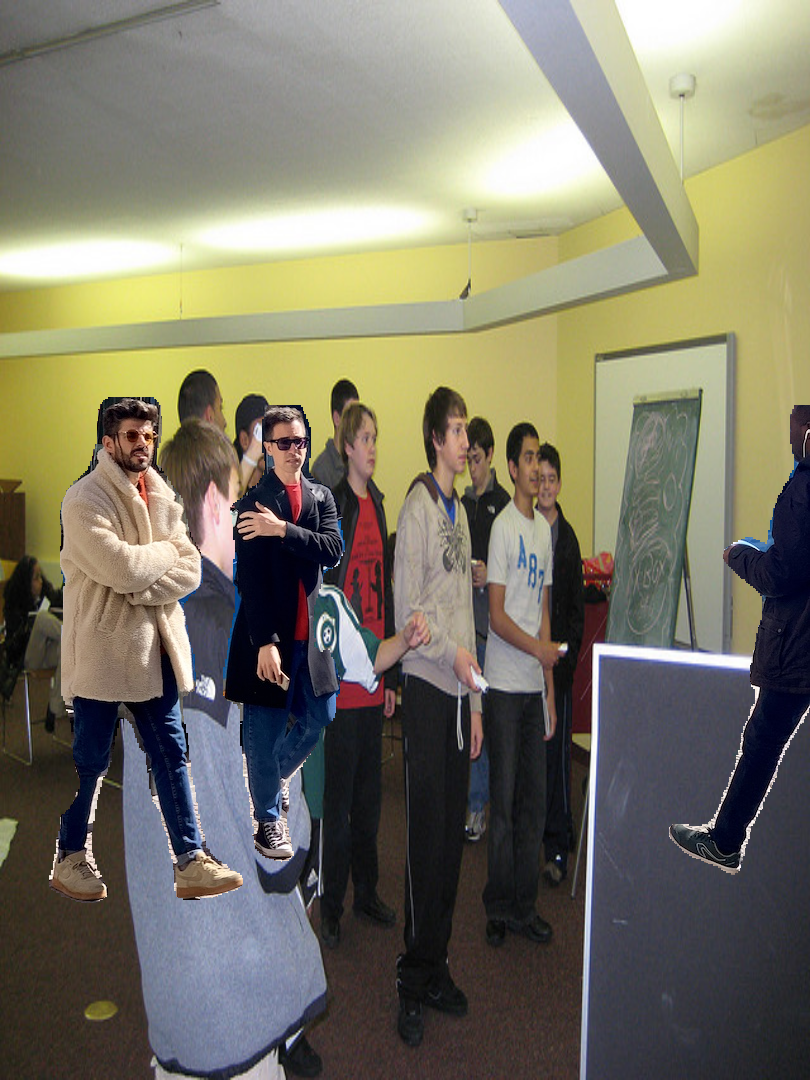
mode: image:背景换成 images/ 里另一张 COCO 图怎么跑出这四张(三条命令):第一条进目录、确认模型和素材在;第二条单图分割,把结果存成 out.jpg;第三条改配置后再跑一次,就换了一种背景。
cd ~/ros2_ws/src/xflz_eai_car1/vision/06_semantic_segmentation
ls models/ images/
python src/app.py --image images/bus.jpg --save out.jpg
启动时还会刷几行 W RKNN: … not match with rknn runtime version 和 query RKNN_QUERY_INPUT_DYNAMIC_RANGE error。这是静态 shape 模型的正常提示,不影响结果 —— 别以为出错了。
🔍 看什么:盯三处。
- 巴士为什么整辆没了 —— 不是模型没认出车(它认出了,就在那 4 个实例里),是被配置挡在了外面。第 04 节步骤 6 会指给你看。
- 人的边缘 —— 头发、手臂和背景交界处是贴着轮廓走的,不是方框。但仔细看第 ③ 张:轮廓外面挂着一圈颜色略暗的边,这就是第 02 节的第三问。
- 最右边那个人 —— 只露出半个身子、还被人挡住,照样被留下了。同一张画面里的三个人都能抠,说明这一步与人数无关。
这就是本实验最终要呈现的现象。此时照做、先看懂它就行;第 05 节会带你亲手跑出同样的画面,并补上实时相机那一路。
04原理:六格链路,把 32 个数拼成一个人的轮廓
检测只回答「框在哪」,分割再补一句「框里每一个像素算不算人」。而模型并不直接画这张图 —— 它给每个实例 32 个数,让 32 张公共模板图加权叠出轮廓。
打个比方:模型预先备好 32 张「形状印章」,谁要用就报一份配料表 —— 每个物体只回传 32 个系数,说明「这 32 张印章各用多少」。
揭个盖:印章盖下去就定了,而这里是数值加权,同一份配料表在不同画面上叠出来的轮廓会跟着变;而且叠出来的是 0~1 的概率,不是硬边 —— 所以才需要 mask_thr 这条线把它切成「是 / 不是」。
这一节用六个步骤走完整条链。第 02 节的三个问题各有落点:① 每个像素归谁 → 步骤 4;② 报了 4 个为什么只剩 3 个 → 步骤 3 和步骤 6;③ 边缘那圈暗边哪来的 → 步骤 5。步骤 1、2 是把画面送进模型的必要准备。
1640×480 的画面,模型为什么非要一个 640 见方的黑边方块?
吃什么:任意尺寸的一帧 BGR 图(bus.jpg 是 810×1080)。做什么:按长边等比缩到 640,空出来的地方填纯黑,再把 BGR 换成 RGB。吐什么:一张 640×640×3 的 uint8 图。
算式很短:ratio = 640 / max(h, w) = 640 / 1080 ≈ 0.593,于是画面缩成 480×640,左右各补 (640-480)//2 = 80 像素黑边。这也是训练时喂给模型的固定形状 —— 神经网络只认死尺寸。
动它会怎样:填充色必须是 0 而不是常见的 114 灰边,通道必须是 RGB 而不是 OpenCV 默认的 BGR。这两处任何一个错,模型看到的分布就和训练时不一样 —— 症状不是报错,而是掩码整体错位或糊掉,很难反查。
2一次吐出 13 张张量,哪张是框、哪张是形状?
吃什么:那张 640 见方的图。做什么:过一遍 yolov8n-seg(3.2M 参数,3 个检测层)。吐什么:13 个 numpy 数组。
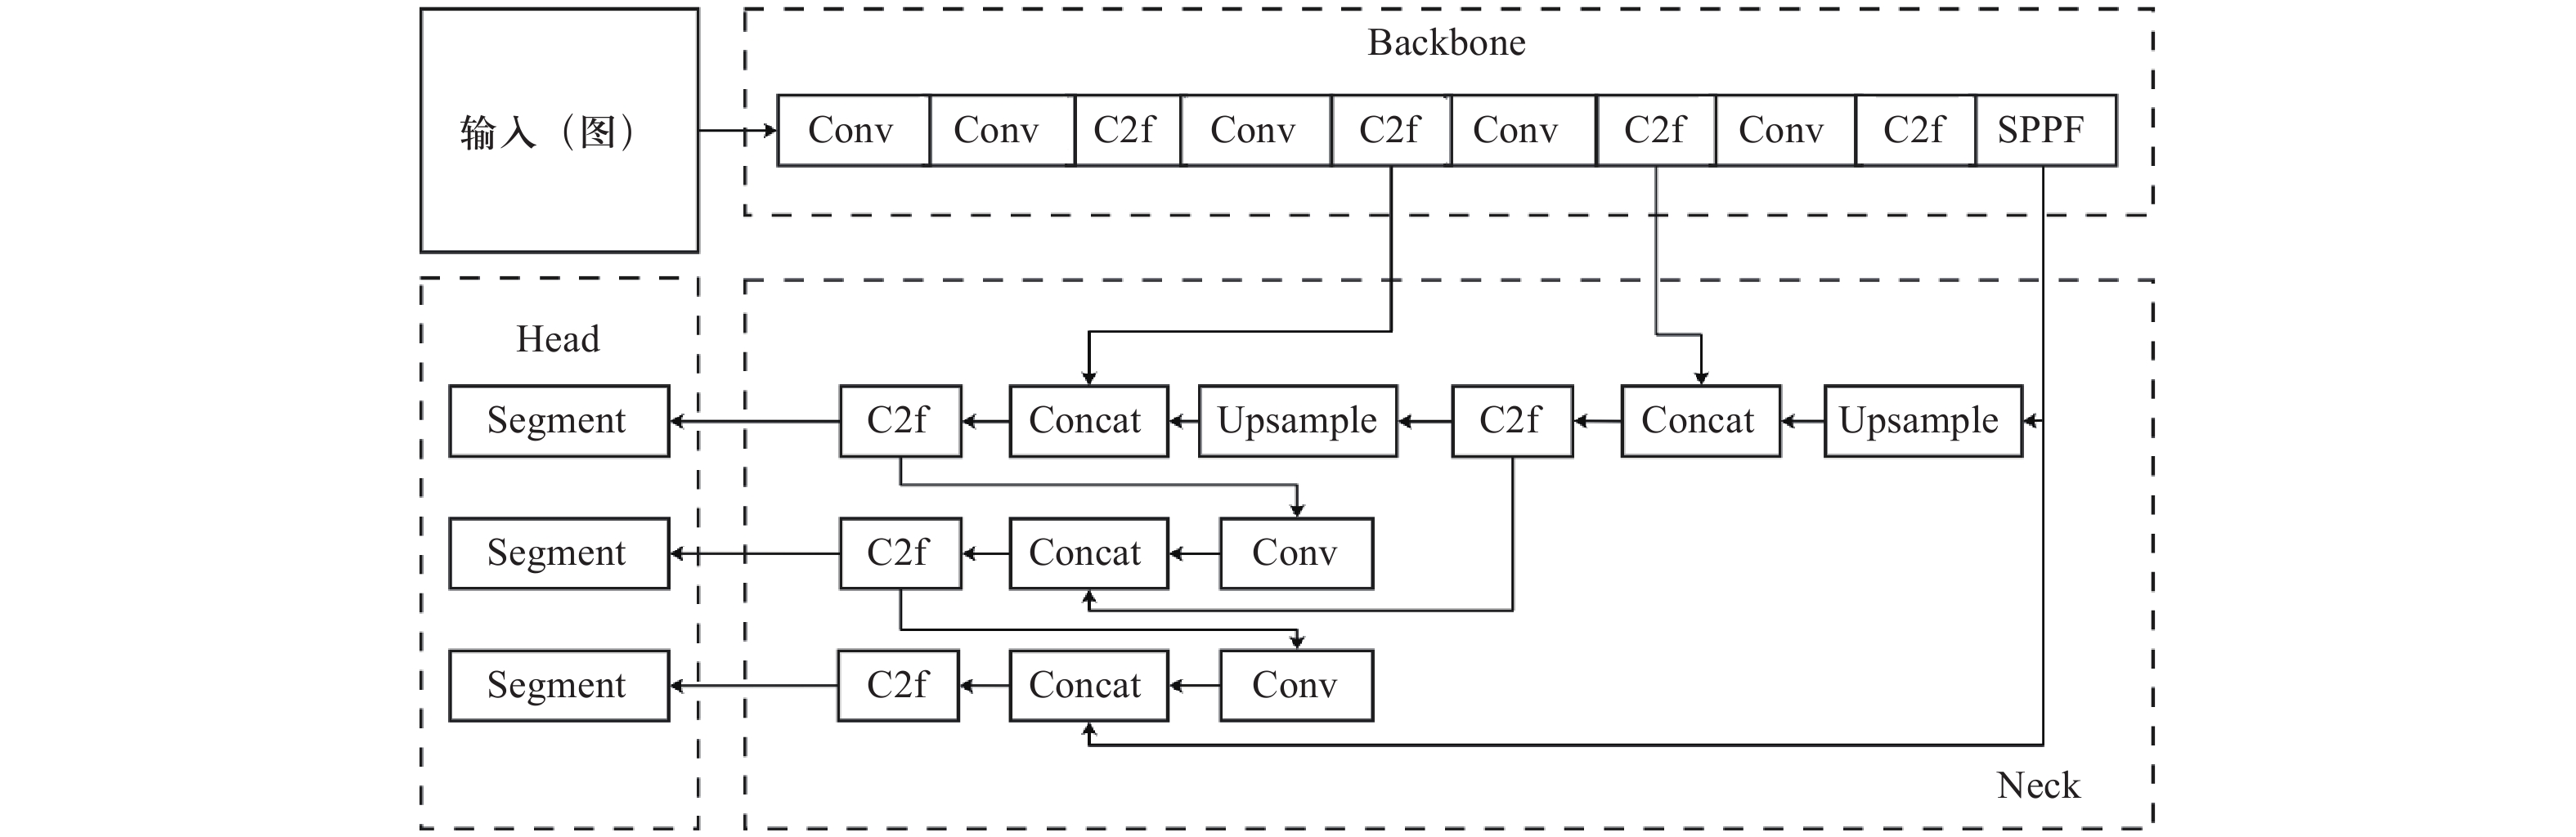
| 输出(每层 4 组) | 是什么 |
|---|---|
box 64 | 4 条边 × 16 个 bin 的分布,用来还原框 |
cls 80 | 这一格属于 80 个 COCO 类各自的分数 |
cls_sum 1 | 80 个分数的和,分割模型特有 |
mc 32 | 掩码系数:形状要用多少(步骤 4 的主角) |
第 13 张是 proto:32×160×160 的原型表,全局只有一份,不属于任何一个检测层。
动它会怎样:这 13 张布局与解码代码是死契约(postprocess.py 用 len(outputs)//3 分组)。换模型版本前先数输出数,少一张就会在解码时直接抛形状错误。
3几千个格子 × 80 个类别,怎么收敛成「画面里有 4 个东西」?
先猜一下:640 见方的图被切成 80×80、40×40、20×20 三种网格,一共 6400+1600+400 个格子。模型会吐出多少个候选框?几百个?还是几千个?—— 先写下你的答案,再看下面。
答案是 8400 个格子每格都有候选,几乎全是噪音。收敛靠三步:
- 还原框:64 个数是 4 条边各 16 个 bin 的分布,取加权期望得到偏移量,再加上格子中心与步长,得到 8400 个框。
- 筛分数:用
cls最大分 ×cls_sum去比score_thr = 0.25,绝大多格子在这一次比较里出局。 - 压重复:同一个物体周围一圈格子都会给框,用 NMS(
iou_thr = 0.45)按重叠度只留一个。
剩下的就是那 4 个实例:3 个 person + 1 个 bus。终端打印的 4 就是这一步的结果。
动它会怎样:score_thr 调低 → 混进大量误检,画面里出现半透明的碎掩码;调高 → 只露出半个身子的人直接漏掉,整帧可能变黑。iou_thr 调低 → 画面里挤在一起的两个人都被并成一个。
432 个数乘 32 张模板图,怎么就叠出一个人的轮廓?
这是第 02 节第一问的答案,也是全节最反直觉的一步。模型没有画出这个人的轮廓,它只是报了一份 32 个数的「配料表」。
一张全分辨率概率图就有 40 万个数。要输出它,中间层得堆到百万级参数 —— 边缘小板上跑不动。
mc(N×32)乘 proto(32×25600),一次矩阵乘就还原出 N 张 160×160 —— 参数量降了两个数量级。
乘完再套一个 sigmoid,把数值压进 0~1。所以每人拿到的是一张概率小图:越靠近身体中心越接近 1,越往外越小,边界附近正好落在 0.5 上下。
动它会怎样:这一步没有可调参数 —— 它由 mc 和 proto 决定。这也是它最容易失效的地方:模板只有 160×160,一个人只占几十个像素、或者细到「一根手指」时,32 张低分辨率模板根本表达不出那个形状,边缘必然是圆钝的。
5160×160 的小图,凭什么贴到 640×640 上刚好合身?
三件事按顺序做,缺一件就会错位或多出残片:
- 放大 4 倍:160 → 640,双线性插值。所以边缘天生是一条模糊的过渡带,不是刀切的硬边。
- 框外清零:把这个实例的检测框以外全部置 0。少了这一步,一个人的掩码会顺着模板溢出到别人的框里,两人贴在一起时就粘成一团。
- 切黑白:
seg_img > mask_thr(默认 0.5)把概率图变成True/False。
为什么 0.5 是默认值:sigmoid 在 0 处的取值正好是 0.5,所以 0.5 这条线基本落在「模型认为的边界」上。调高(0.7)→ 只保留更有把握的内部,边缘往里缩,头发和手指先丢;调低(0.3)→ 边界往外胀,把旧背景带进来一圈 —— 这就是第 02 节第三问那圈暗边的来源。
动它会怎样:mask_thr 是取舍而非精度。要「完整包含」时调到 0.3(量面积),要「一定有把握」时调到 0.7(确认这里确实有人)。0.5 是大多数场景的起点。
64 个实例里只留 3 个人,再把背景换掉 —— 到底谁在决定?
这是第 02 节第二问的答案,也是这个实验最容易被忽略的一处:1 个实例被丢掉,发生在后处理最末一段,不在模型里。
- 选类:把 N 张掩码按
model.classes挑行([0]只留 person),再把挑中的若干张按位或成一张 —— 只要有一个实例在这一点上是人,这一点就是前景。多人场景下所有人才会都被保留。 - 缩回原图:这时掩码还是 640 见方。用步骤 1 存下的
pad_x / pad_y / ratio反算,再用最近邻缩回 810×1080。必须最近邻:双线性会把 0/1 糊成小数,边缘又多一圈灰。 - 合成:
compose()做一次逐像素选择 —— 掩码为真的地方留原图,为假的地方填背景。三种模式只差「填什么」:black填 0,solid填background.color,image填一张缩放到同尺寸的背景图。
动它会怎样:classes 改成 [5] → 巴士留下、三个人变成黑色剪影(第 06 节给了这张图);改成空列表 [] → 80 类全保留,什么都不会消失。background.color 是 BGR 顺序,想要红写 [0,0,255]。
classes 只放行了 person。先认识 4 个词
和画面同样大(或按比例缩放)的黑白图:白 = 留原图,黑 = 换成背景。什么时候失效:两个人紧贴着走,两张掩码会按位或粘成一整团。
模型内部 32 张 160×160 的公共灰度图,所有物体共用,谁都不是专属。什么时候失效:只占几十像素的小目标,低分辨率模板表达不出来。
每个实例的 32 个数,说明「这 32 张模板各用多少」。什么时候失效:实例被 NMS 误合并时,这份系数就属于错的框。
把 0~1 概率图切成「是 / 不是」的那条线,默认 0.5,正好是 sigmoid 的中点。什么时候失效:环境光一变,模型输出的置信度整体偏移,同一条线就不在边界上了。
什么时候会翻车:五个真实边界选读 1 分钟
- 一个人都没检出 → 整帧变黑。代码里写得很直白:没有前景掩码时它就造一张全零的,于是背景模式把整个画面都换掉了。屏幕上只剩一片黑,看起来像「坏了」,其实是没检出人 —— 退后一点、露出上半身再试。
- 杂乱背景 → 边缘挂残片。树影、栏杆、花纹墙最容易在轮廓外留一圈碎点,因为它们和人体边缘的纹理太像。调高
mask_thr能压掉一部分,代价是头发先丢。 - 夜间 / 强逆光 → 掩码整体碎裂。模型的训练集以白天街景为主,光线条件一变,置信度整体下移,同一条 0.5 就不再落在边界上。
- 两人贴身 → 掩码粘连。按位或会把两个人并成一个人形,中间那道缝补上了。想要分开,得绕过
foreground_mask()直接逐实例取掩码。 - 太远 / 只露一角 → 漏检。框都没生成,就没有后面的步骤可言。这不是分割的问题,是检测的极限。
| 步 | 数据变成什么 | 为什么非它不可 / 少了会怎样 | 谁在干 | 动参数会怎样 |
|---|---|---|---|---|
| 1 | 任意尺寸 → 640×640×3 RGB,两侧黑边 | 模型只认死尺寸;补 114 灰边或忘了转 RGB,掩码整体错位 | letterbox()to_rgb() | 改 imgsz 必须同步重转模型,否则形状对不上 |
| 2 | 一张图 → 13 个数组 | 模型本体,唯一跑在 NPU 上的那格 | predict() | 无参数;换模型要核输出数 = 13 |
| 3 | 8400 个格子 → 4 个实例(框 + 类 + 32 系数) | 不筛就把 8400 个噪音框全画出来 | dfl_decode / nms | score_thr↓ 误检;↑ 漏检;iou_thr↓ 两人并一个 |
| 4 | (N,32) × (32,25600) → N 张 160×160 概率图 | 不这么分两段,掩码输出的参数量就压不进边缘设备 | mc @ protosigmoid | 无参数;小目标边缘必然圆钝 |
| 5 | 160 → 640,框外清零,大于 mask_thr 才是人 | 不清零 → 掩码溢出到别人的框;不放大 → 与原图对不上 | cv2.resize框裁剪 / 阈值 | mask_thr↑ 收缩丢手指;↓ 外胀带残片 |
| 6 | N 张 → 一张原图尺寸前景掩码 → 一张合成图 | 不选类 → 巴士也留下;不缩回原图 → 尺寸错 | foreground_maskcompose | classes 决定留谁;mode 决定填什么 |
这张表五列,只看第 2、5 两列就能回答第 02 节的三问:第 2 列告诉你数据变成了什么,第 5 列告诉你哪个旋钮管哪一处。函数名放第四列,想追代码时再看 —— 它们都在 src/postprocess.py 与 src/app.py 里。
05实操:单图 / 三种背景 / 三线程三条命令
学员敲的是一条命令,脑子里却没有「这一帧经过了谁」。先把这张对照表摆出来 —— 每一行都是第 04 节某一格的落地,第 5 列写明它对应原理的哪一步。
| 环节 | 函数(文件) | 吃哪个参数 | 对应原理第几步 |
|---|---|---|---|
| 取流 | cv2.imread / Ros2Camera.read(app.py:71 / ros2_source.py:82) | --image --ros | 链外(纯工程) |
| 进推理池 | RKNNPool.put/get(rknnpool.py:70) | pool.workers | 链外,只影响帧率 |
| 预处理 | prepare_input(preprocess.py:45) | model.imgsz | 步骤 1 |
| 推理 | RKNNBackend.predict(backend.py:42) | pool.core_mask | 步骤 2 |
| 解码 | decode_outputs(postprocess.py:81) | score_thr iou_thr mask_thr | 步骤 3、4、5 |
| 掩码映射回原图 | letterbox 反算 + cv2.resize(app.py:36-41) | (无,自动跟随) | 步骤 6 |
| 选类与合成 | foreground_mask / compose(app.py:32 / background.py:21) | model.classes background.* | 步骤 6 |
| 推流 | MjpegServer.set_frame(mjpeg_server.py:61) | server.port stream_name | 链外(纯工程) |
第 03 节那四张图,现在亲手复现一遍。
-
单图跑一遍,先看清 4 和 3约 3 分钟
进目录,确认模型(
yolov8n-seg.rknn,约 7MB)和素材都在。第一条命令不产出图,只是确认素材齐全。cd ~/ros2_ws/src/xflz_eai_car1/vision/06_semantic_segmentation ls models/ images/
models/: yolov8n-seg.rknn yolov8n-seg.onnx coco_80_labels_list.txt images/: bus.jpg + 20 张 COCO 量化校准图单图模式:读一张图、只起 1 个 worker、跑一次、存盘退出。参数
--image给输入,--save给输出文件名。python src/app.py --image images/bus.jpg --save out.jpg
[seg] 4 instances saved -> out.jpg打开
out.jpg:三名行人在,巴士和街道全黑。顺手试一次只给--image不给--save—— 它会提示use --save or --display for single image然后退出,不会把图显示在你眼前。 -
换三种背景,比一比边缘约 5 分钟
背景由
background这一段决定:mode选模式,color只在solid用(BGR 顺序),image只在image用。这段是配置内容,不用执行:background: mode: black # black | solid | image color: [0, 0, 0] # solid 的填充色,BGR 顺序 image: "" # image 模式的背景图
改一次配置跑一次,换个输出文件名好放在一起比(
out_black.png存出来的就是第 03 节第 ② 张):python src/app.py --image images/bus.jpg --save out_black.png
[seg] 4 instances saved -> out_black.png一定先试
black。纯黑最容易暴露问题:边缘有没有毛边、有没有把旧背景的残片带进来,一眼就看清。然后试
solid:把mode改成solid、color改成[0, 200, 0](BGR → 亮绿),重跑一次。那圈暗边会变得非常明显 —— 它就是第 04 节步骤 5 说的「往外胀」。最后试
image:mode改image,image填一张现成的图,例如images/000000075612.jpg(images/里那 20 张 COCO 图随便挑一张就行,不用另外找素材)。路径是按「你运行命令时所在的目录」解析的 —— 只要按本节在项目根下运行,写images/xxx.jpg就对了;写成不存在的文件,合成时会抛cannot read background image。 -
接上相机,看三线程把帧率抢回来约 8 分钟
板上标准走法是 ROS 话题(HP60C 直连读不了,opencv 未编 libv4l)。两个终端,先起驱动再跑程序,两边的
ROS_DOMAIN_ID必须一致(N 取 0~101 任一整数,每台设备各选各的,别都设成同一个值)。终端一 · 起相机驱动
source /opt/ros/humble/setup.bash && source ~/ros2_ws/install/setup.bash
export ROS_DOMAIN_ID=N
ros2 launch ascamera hp60c.launch.py
日志持续滚动,无 ERROR / 无红字终端二 · 跑分割 + 推流
source /opt/ros/humble/setup.bash && source ~/ros2_ws/install/setup.bash
export ROS_DOMAIN_ID=N
cd ~/ros2_ws/src/xflz_eai_car1/vision/06_semantic_segmentation
python src/app.py --ros
[seg] 30帧平均帧率: xx.x det=1 ← workers: 1 时约 20~40,workers: 3 时约 40~60 ← 浏览器打开 http://<板IP>:8080/seg.mjpg想验证多线程真的起作用:把
pool.workers从 3 改成 1,重跑一遍,对比终端那行帧率。注意core_mask默认是auto(驱动自己调度),改成round_robin才会按tid % 3把三个 worker 分别钉在 NPU 的三个核上。帧率明显偏低时,这两个值一起看。对着镜头挥挥手、抓抓头发 —— 看边缘跟不跟得住。头发最难:如果头发边缘也抠得干净,说明效果很好。
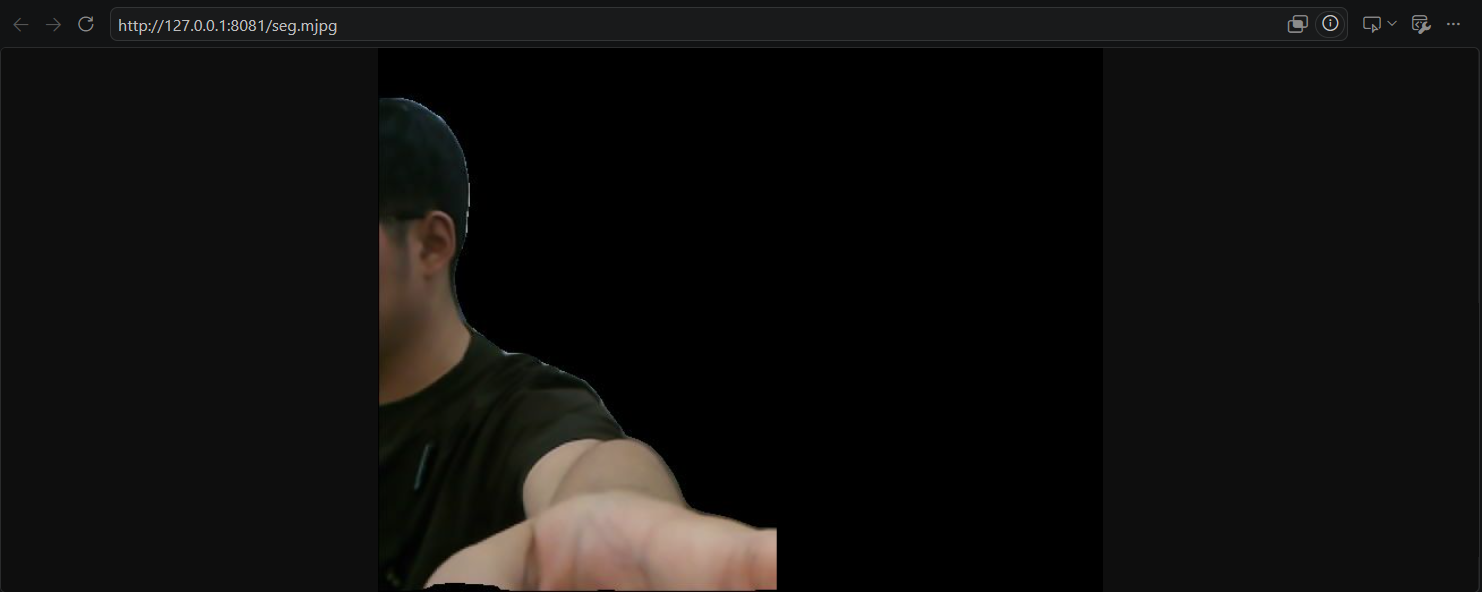
图 5-1|浏览器里的实时画面:手臂伸到镜头前也没被切掉,背景一直是黑的(那次运行用 --port开在 8081)
[seg] 4 instances。两处对上了,说明取流、预处理、解码、掩码映射、合成这五段你已完整走通。命令 → 函数 → 文件:你敲的每一行到底经过了谁
| 命令 / 参数 | 经过的函数(文件) | 影响链上哪一段 / 改坏了会怎样 |
|---|---|---|
--image X --save Y | main() 单图分支(app.py:70)→ imwrite(:86) | 取流方式;只给 --image 会提示并退出 |
--ros | Ros2Camera.open/read(ros2_source.py:50) | 换成话题取流;驱动没起就打印 cannot open ros topic 并退出 |
--video / --camera | cv2.VideoCapture(app.py:106) | 板上 --camera 直连会失败(opencv 未编 libv4l) |
--config / --port / --display | load_config(config.py:24)/MjpegServer(mjpeg_server.py:38) | 换配置文件、换推流端口、开本地窗口 |
model.imgsz | prepare_input(preprocess.py:45) | 步骤 1;改它必须同步重转模型 |
model.score_thr | decode_outputs(postprocess.py:83) | 步骤 3;调低误检、调高漏检 |
model.iou_thr | nms(postprocess.py:50) | 步骤 3;调低会把并排的两个人合成一个 |
model.mask_thr | decode_outputs(postprocess.py:85、:130) | 步骤 5;边缘胀缩的唯一旋钮 |
model.classes | foreground_mask(postprocess.py:133) | 步骤 6;决定 4 个里留下几个 |
pool.workers / core_mask | RKNNPool / backend_factory(rknnpool.py:16) | 只影响帧率,不影响掩码质量 |
background.mode/color/image | compose(background.py:21) | 步骤 6 输出的那一层;image 路径写错直接抛错 |
server.port / stream_name | MjpegServer(mjpeg_server.py:38) | 推流地址;端口被占用时启动即报错 |
你该看到的画面
人形完整,边缘略有过渡(正常)。若有一圈明显光晕或旧背景残片 → 掩码偏大,调高 mask_thr。
证件照效果。注意 color 是 BGR:想要红写 [0,0,255],写成 [255,0,0] 会得到蓝。
背景图会被缩放到画面大小。人站在风景里,效果最接近视频会议。
不是坏了:没有前景掩码时程序会造一张全零的,于是整幅画面都被换掉。退后、露上半身、或降低 score_thr。
render() 里的掩码映射与合成跑在主线程,是另一个瓶颈。踩坑速查
| 现象 | 原因 | 怎么办 |
|---|---|---|
| 掩码整体错位、偏到一边 | 填充色或通道顺序和训练时不一致 | 确认 letterbox 填 0、且 to_rgb 已执行(转换侧 rgb2bgr=False) |
提示 python: command not found | 没有激活板上的 venv(板端 Python 3.10 在 ~/ros2_venv) | source ~/ros2_venv/bin/activate,或直接用 ~/ros2_venv/bin/python src/app.py … |
--ros 一跑就报 ImportError: librcl_action.so | 忘了 source ROS 环境,venv 里的 rclpy 找不到底层库 | 先 source /opt/ros/humble/setup.bash 和 source ~/ros2_ws/install/setup.bash,再激活 venv |
启动刷一屏 W RKNN: … version … not match、dynamic range | 模型由 toolkit 2.3.0 转换、板上运行时 2.1.0;静态 shape 模型本就不支持动态范围查询 | 不用管,属正常提示 —— 只要最后打出 [seg] N instances 就说明推理成功 |
| 人抠出来了但边缘一圈碎渣 | 掩码边界外扩,把旧背景带进来 | model.mask_thr 从 0.5 调到 0.6~0.7 |
| 人只剩个身子,手指和头发没了 | mask_thr 太高 | 降到 0.4 左右再看 |
| 画面里别人的东西也被抠出来 | classes 没限定 | model.classes: [0] 只留 person;想看全部就写 [] |
| 帧率只有二十几 | 只开了 1 个 worker,或没绑核 | pool.workers: 3;再试 core_mask: round_robin |
| 跑到一半程序崩了 | 多个 worker 共用同一个 RKNN 实例 | 每个 worker 必须独立实例(本仓 RKNNPool 已这么做,别自己改回去) |
| 背景图不显示 | 路径不是相对项目根,或文件不存在 | 确认文件在、尺寸别太怪;改成绝对路径最稳 |
--ros 起不来,报 cannot open ros topic | 驱动没起,或两个终端 ROS_DOMAIN_ID 不一致,或有人 remap 过话题 | 先起 ascamera;两边 export 同一个 N;话题保持 /ascamera_hp60c/camera_publisher/rgb0/image |
| 启动就打印一段 pip 安装指引后退出 | 缺 mjpeg_streamer | 按提示装:pip install -i https://pypi.tuna.tsinghua.edu.cn/simple mjpeg_streamer |
进阶(可选)
进阶 1 · 把背景虚化而不是替换约 20 分钟
比换背景更自然的效果是把背景糊掉 —— 人清晰、身后柔化,很多会议软件用的就是这个。
改动很小:合成那一步,把「背景源」从新图换成模糊后的原图。也就是 compose() 里 image 模式的那张 bg,换成 cv2.GaussianBlur(原图, (25,25), 0)。核心公式没变,只是 I_bg 换了。
观察点:核越大越糊;但核太大时人的边缘会和背景糊在一起,反而露出「剪贴感」。
进阶 2 · 把掩码存成带透明通道的 PNG约 20 分钟
把掩码当成 Alpha 通道塞进 PNG,就得到一张「透明背景人像」,可以直接贴进 PPT 或海报 —— 这是设计工作流的标准产物。
BGRA = 原图 + alpha 通道(掩码 * 255)
cv2.imwrite('cutout.png', BGRA)
注意必须存 .png:JPG 不支持透明,会把透明区域变成白块。
进阶 3 · 用同一套掩码数人头约 25 分钟
既然每个实例都带类别,数人只是把解码结果按类统计一下:对 res.classes 做 np.unique(..., return_counts=True),取类 0 的数量,就是画面里的人数。
想验证它和画面对得上:bus.jpg 上会得到 {0: 3, 5: 1} —— 3 个 person、1 个 bus,正好解释终端那句 4 instances 与画面上 3 个人的落差。
注意这只能数「这一帧」,要跨帧知道「还是不是同一个人」,得等 EXP-07 的跟踪。
🧪 Vibe Coding · 自己把这段代码读明白约 20 分钟
你要产出三样:模块职责表 → 控制流流程图 → 时序图。提示词已给全,直接复制去问 AI;产出后与真源码逐条对照,差异处就是设计决策。
提示词 1 · 模块职责分析
请阅读这个语义分割项目的五个文件:src/app.py、src/preprocess.py、src/postprocess.py、src/background.py、src/rknnpool.py。
它们共同完成「读一帧图 → 抠出人 → 换成新背景」。
请输出一张表,每行一个模块,四列:模块名 / 一句话职责 / 被谁调用 / 从哪个参数取值。
要求指出每个模块的关键函数所在行号;说不清「谁调谁」的地方请明确标注,不要猜。
提示词 2 · 控制流流程图
请按「主线程处理一帧」的视角,为 src/app.py 的 main() 画一张控制流流程图。
必须包含:四个输入分支(--image / --video / --camera / --ros)如何汇合;主循环里取帧失败、推理结果为空这两条异常路径;退出循环后释放池与服务。
每个框里写函数名,判断框写条件,不要用「处理」「分析」这类空词。
提示词 3 · 时序图
请为实时模式(--ros)画一张时序图,参与者必须使用真实名字:ros2_camera 节点、Ros2Camera 回调、RKNNPool 的 worker 线程、主线程、MjpegServer。
按时间顺序标出:话题消息到达、入队、worker 取帧推理、结果出队、render 合成、set_frame 推流。
并标注主线程与 worker 是并行流水线(不是同步等待)。
自查三问:每个模块都能指到真实文件与行号?流程图里有分支和退出条件?时序图的参与者是真名而不是「系统 / 用户」?
三处必然的差异,先给你对答案(这些差异就是工程要解决的问题):
| 差异点 | AI 版常见写法 | 工程版(本仓) | 为什么工程这么写 |
|---|---|---|---|
| 类别过滤放在哪 | 在解码阶段就用 classes 过滤,只保留想要的类 | 解码不管类,foreground_mask() 才按 classes 挑行(postprocess.py:133) | 日志要报告全部检出(4 instances),抠图只留 person。提前过滤会让终端那句 4 变成 3,反而看不出「有东西被丢掉了」 |
| 掩码要不要按框裁剪 | 上采样后直接阈值,全图都算 | 先把这个实例的框外清零,再阈值(postprocess.py:124-130) | 32 张低分辨率模板拼出来的掩码会溢出到别人的框里;不清零,两人靠近时掩码会粘成一片 |
| 多线程怎么写 | ThreadPoolExecutor.map 每帧新建任务,共享一个模型对象 | 固定 N 个常驻 worker,每个持独立 RKNN 实例,round_robin 时按 tid%3 绑核(rknnpool.py:16-23) | NPU 上下文不能跨线程共享,共享实例会直接崩;绑核是为了避免多个 worker 抢同一个核 |
| 背景合成的写法 | addWeighted 或三通道各算一次浮点乘 | out[~fg_mask] = 填充值 的布尔索引(background.py:28-39) | 掩码本来就是 0/1,不需要浮点 alpha 混合;布尔索引一次写完三个通道,省掉 40 万次乘法 |
改一处、先预测再验证:把 model.classes 改成 [5],先写下你认为 out.jpg 会变成什么样,再跑一次对答案。
06互动:拖 mask_thr 和 classes,看 4 变 3、边缘胀缩
📌 这一节是「掌握检查」:亲手改一个参数,看现象是否朝你预期的方向变,还要能说出为什么 —— 说得出,才算掌握。
第 05 节里改一次配置只能出一个结果,还得重跑。这里把步骤 5 和步骤 6 搬到页面上:同一帧合成画面、同一套 4 个实例,两个参数随便拖,结果实时重算 —— 不用设备也能看清「谁决定留下谁、谁决定边缘在哪」。
classes 放行,红色 = 被挡在外面;黑色是 mode: black 的背景。掩码按 sigmoid(到轮廓的距离) 逐像素重算,不是贴图切换:调 mask_thr 就是在给那张概率图换一条切线。怎么读出规律:先只看 classes —— 4 个实例的检出数不变,变的只是「放行几个」;再看 mask_thr —— 放行的实例不变,变的是每个人轮廓的胖瘦。两件事互不干扰,这正是第 04 节步骤 5 与步骤 6 的分工。
只剩身体核心:头顶、手臂末端、脚先消失。这是「宁缺」的一侧。
sigmoid 的中点,边缘基本贴合真实边界。默认值就是它。
轮廓外挂上一圈旧背景的颜色 —— 第 02 节第三问那圈暗边,就是它。
车留下、人变黑剪影。检出一直是 4 个,变的只是放行名单。
切到 [5] 只留 bus 时,真机上跑出来是这样 —— 巴士完整保留,三名行人变成纯黑剪影。注意这时终端打的仍然是 [seg] 4 instances,一个字都没变:检出数压根不受 classes 影响。
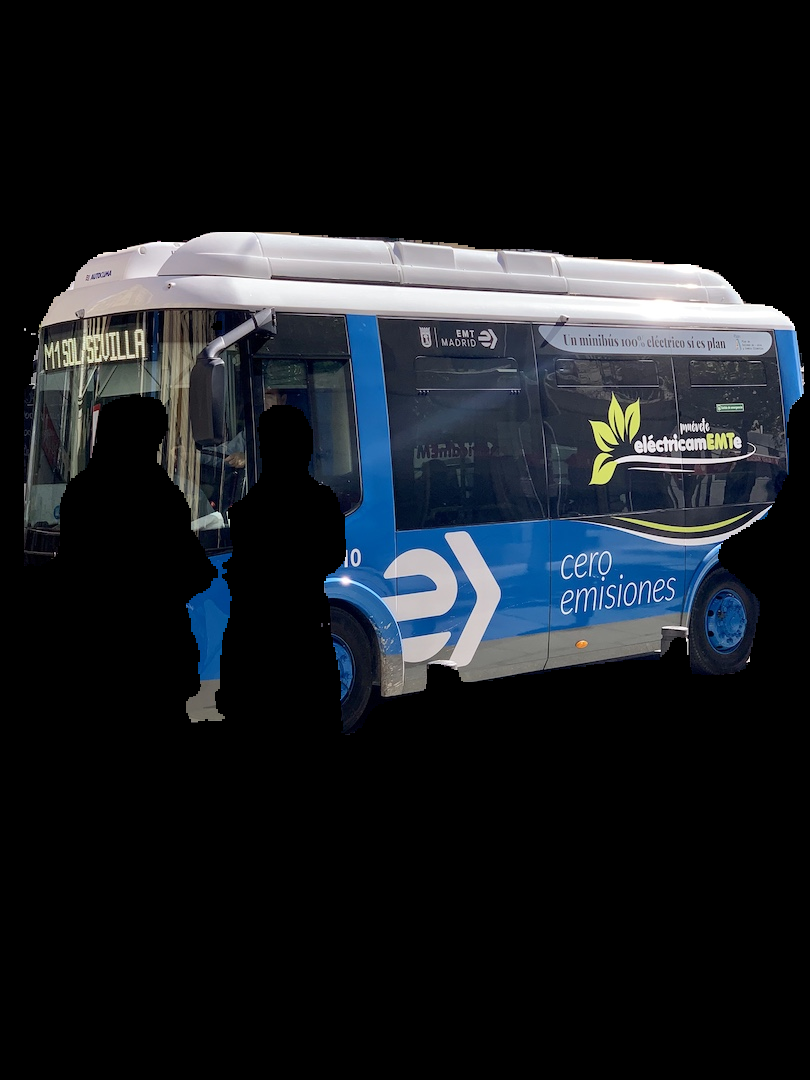
classes: [5]:车在、人变黑剪影,日志仍是 4三种典型设置
| mask_thr | 你会看到 | 什么时候用 |
|---|---|---|
| 0.3(低) | 白区外胀,头发丝都算进来了,但同时带进一圈背景残片 | 要「完整包含」时,比如量伤口的面积 |
| 0.5 | 边界大致落在真实轮廓上 | 默认值,绝大多数场景从这里起步 |
| 0.8(高) | 白区收缩,只剩身体核心,手指和发梢丢失 | 只要「一定有把握的区域」时,比如确认这里确实有人 |
mask_thr 回答的是「有多确定才算人」,classes 回答的是「谁有资格被算人」。前者改边缘,后者改名单,一次只动一个,画面变化才对得上号。07验证:三道小测
回页首对照「实验目标」逐条自检:① 能不能说清检测与分割的差别、并解释「报 4 留 3」→ 试 Q1 与 Q2;② bus.jpg 的单图流程跑通没有、out.jpg 与第 03 节那四张对得上没有,翻回第 05 节自查;③ 三个参数是否都亲手改过一次、能否说出各自改哪里 → 试 Q3,并回第 06 节把 mask_thr 拖到两端看一眼。答不上的条目回到对应小节补完再交卷 —— 三条全 ✓,这一课就完成了。
mask_thr 去切。第三个选项是常见误解:32 张原型是所有物体共用的形状基元,不分类别。[seg] 4 instances,可 out.jpg 里只有 3 个人、巴士整辆变黑。原因是什么?classes: [0] 只把 person 的掩码并进前景,bus 被判成背景换掉了4 是模型检出的实例数(打印在解码之后),3 是被保留的实例数(由 foreground_mask() 按 classes 决定)。把配置改成 [5],画面就反过来:车在、人变黑剪影。记住这条分界,就不会再被日志和画面打架搞晕。model.score_thr 调高model.mask_thr 从 0.5 调到 0.6~0.7pool.workers 改成 1mask_thr 会让白区收缩、边缘收紧 —— 但别贪心:过了 0.8,手指和发梢会先消失。score_thr 管的是「这个框要不要」,改它只会让整个人消失,不会修边缘;workers 只影响帧率。08章节总结:检出是模型的活,留谁是 classes 的活
这页讲了什么,它们怎么串起来
| 概念 | 它解决了什么 | 和别的关系 |
|---|---|---|
| letterbox + RGB | 把任意尺寸的画面变成模型认得的 640 见方 | 上游是输入帧,下游决定掩码能不能正着映射回原图;pad_x/pad_y/ratio 一路传到步骤 6 才用完 |
| 13 输出 | 一次推理同时给出框、类别与形状信息 | 上游靠步骤 2 的 NPU 推理产出,下游被步骤 3 拆成三层四组逐层解码 |
| DFL + NMS | 把 8400 个格子的候选压成 4 个实例 | 直接决定 score_thr/iou_thr 的后果:误检、漏检、两人并一个 |
mc @ proto | 用 32 个数 + 32 张公共模板还原出逐像素轮廓 | 上游吃步骤 3 留下的系数,下游给出 160×160 概率图;它是「不直接输出掩码」换来的速度,代价是边缘模糊 |
mask_thr | 把概率切成黑白,决定边界落在哪 | 上游接上采样后的概率图,下游直接决定边缘胀缩与前景像素数 |
foreground_mask | 按 classes 挑实例、按位或成一张前景掩码 | 上游吃 N 张实例掩码,下游是合成唯一要用的 0/1 图;「报 4 留 3」就发生在这里 |
compose 合成 | 白处留原图、黑处贴背景,一台虚拟背景机成型 | 最末端:mode 只决定「填什么」,不改变掩码质量 |
推理池 pool.workers | 用多核把分割多出来的那几万倍计算量抢回一部分帧率 | 横向于整条链:只影响 FPS,不影响掩码;3 worker 约 40~60,1 worker 约 20~40 |
classes 决定 —— 日志和画面本来就可以不一致,这恰恰是你调试的依据;② 直觉是
mask_thr 越高越准,实际是它只是把切线往「宁缺」那头挪:0.7 修掉边缘残影,0.8 开始丢手指,本来就没有「更准」这回事;③ 直觉是分割比检测慢是因为模型更大,实际是慢在要算几十万个像素 —— 模型只有 3.2M 参数,但输出从「几个框」变成「一整张图」。
background.color 是 BGR:想要红写 [0,0,255],写成 [255,0,0] 得到的是蓝;② 数一数就知道的陷阱:
proto 是 160×160,模型空间是 640×640,正好 1/4 —— 所以掩码必须放大 4 倍,边缘那道模糊过渡带是放大带来的,不是 bug;③ 两个「4」不要混:8400 是格子数(80²+40²+20²),4 是 NMS 之后的实例数,
4 instances 里的 4 是后者;④
core_mask 默认是 auto,不是 round_robin —— 想让 3 个 worker 各钉一个 NPU 核,得自己去配置里改;另外 --save 在 --ros 模式下不生效(会打印一行提示然后忽略)。
前置依赖 · 缺一样就跑不起来
| 类型 | 具体项 | 缺了会怎样 / 怎么补 |
|---|---|---|
| 环境 | ROS 2 Humble 两级 source(/opt/ros/humble/setup.bash + ~/ros2_ws/install/setup.bash),相机节点 ascamera hp60c.launch.py,两个终端 ROS_DOMAIN_ID 一致 | 只影响 --ros 实时模式:起不来会打印 cannot open ros topic;单图 --image 不受影响 |
| Python 库 | numpy、opencv-python、pyyaml、rknnlite 2.3.2、mjpeg_streamer | 缺 mjpeg_streamer 会在启动时打印安装指引并 exit 2(进口处就检查);缺 rknnlite 则模型加载失败 |
| 模型 / 资源 | models/yolov8n-seg.rknn(int8,13 输出,约 7MB)与 images/bus.jpg;image 模式还需要一张背景图 | 模型缺了没有任何输出;没有 bus.jpg 就对不上第 03 节那四张;背景图路径写错会在合成时抛 cannot read background image |
| 配置 | config/seg_config.yaml:imgsz: 640、score_thr: 0.25、iou_thr: 0.45、mask_thr: 0.5、classes: [0]、background.mode: black、pool.workers: 3、core_mask: auto | 文件缺失或 key 不全,load_config 直接抛 ConfigError;mode 拼错、或 mode: image 却没写 image 路径,同样在校验时被拦下 |
| 硬件 / 前置实验 | RK3576 板(3 核 NPU,3 worker 才到 40~60 FPS)+ EXP-04 的检测基础(框是怎么来的)+ EXP-05 的推理池概念 | 单核上开 3 个 worker 不会更快;不清楚框从哪来,就理解不了「分割 = 检测 + 掩码」这句话 |
这套代码用在哪儿
- 视频会议 / 直播虚拟背景:每帧出 person 掩码 → 白处留原图、黑处贴背景图 → 推
http://<板IP>:8080/seg.mjpg;进阶 1 把背景源换成高斯模糊的原图,立刻变成「人清晰、背景柔化」。 - 证件照 / 海报抠图:把掩码当 Alpha 通道存成
cutout.png,产出一张透明背景人像,直接交给设计贴图 —— 必须 PNG,JPG 不支持透明。 - 工位人形检测与安全区判定:机器人只需知道「人形区域在哪」,就用这张前景掩码做避让区;
classes换成需要的类,同一套代码还能抠设备、车辆。 - 人流计数:进阶 3 用
np.unique(res.classes, ...)数 person 实例,适合固定机位的粗粒度统计;要跨帧认人就得接 EXP-07。
classes 决定「留谁」,mask_thr 决定「边缘在哪」—— 前者改名单,后者改胖瘦,一次只动一个。下一个实验要把这张「这一帧谁是人」的掩码,变成「跨帧还是不是同一个人」的编号 —— 你现在拿到的每个实例掩码,就是 DeepSORT 的起点。