工业表面缺陷检测
这一章要机器干一件具体的事:看着一张钢板表面图,把上面的夹杂、划痕圈出来,并说出它是哪一类。它也是全课第一个真正用神经网络的实验 —— 前三章你能一行行读懂判断规则,从这一章起,判断权交给了一个训练出来的模型。
01目标:六类缺陷框出,标类别和分数
- 说出一帧图从「进模型」到「画出红框」要走的四步,以及
score_thr、iou_thr分别卡在哪一步 - 用
src/app.py跑通单图与实时两条链路,读出终端打印的「类别 + 置信度 + 左上右下坐标」三件套 - 调出不漏不糊的阈值组合:把
score_thr从 0.25 推到 0.60 再拉回来,说清漏检与误检为什么反着走;并说清这套东西接在产线哪一环、阈值该按什么代价定
images/1.jpg:长条、方图、灰度、彩色都行;缺陷只占画面一角也行
终端里每条缺陷一行:类别 + 置信度 + 左上右下坐标;外加一张红框标注图 out1.jpg
难点:直觉是「框歪了就是模型不准」,实际是检测器根本不负责画图 —— 它吐的是 640 坐标系里的四个数,贴到原图上要「减 pad、除 scale」。这一步对不上,框会整体漂几十像素,而形状一点没错 —— 于是你会去查一个根本没问题的模型。
inclusion 0.826 (181,0,279,302),同时在 out1.jpg 上留下一个贴着缺陷外沿的红框。02问题:钢板上的六种缺陷,人眼盯不住
冷轧带钢从轧机出来后要过质检工位。质检员要做的事,是在钢板扫过镜头的零点几秒里,看清上面有没有下面这六种毛病:
| 模型里叫 | 中文 | 长什么样 |
|---|---|---|
crazing | 裂纹 | 细密的网状浅裂,像干涸的泥地 |
inclusion | 夹杂 | 嵌进去的深色异物块 |
patches | 斑块 | 一大片颜色不均匀 |
pitted_surface | 麻点 | 密密麻麻的小坑,小到只有几十个像素 |
rolled-in_scale | 氧化铁皮压入 | 压进去的暗色氧化层 |
scratches | 划痕 | 一条一条的直线划伤 |
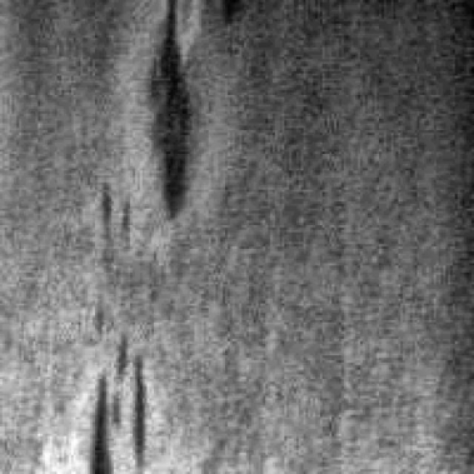
images/1.jpg):中间那几道深色竖向纹理,就是要被框出来的缺陷。人扫一眼就知道「这儿有毛病」,机器拿到的只是每个像素一个 0~255 的灰度数。同一个画面,人和机器的处境完全不同:
| 对比 | 人 | 机器 |
|---|---|---|
| 靠什么 | 眼睛看,大脑判 | 一帧图 = 一张像素表,每格带一个 0~255 的灰度数 |
| 怎么知道「这儿有毛病」 | 看一眼就知道这片纹理不对劲 | ? —— 没有任何一条人写好的规则能描述「细密的网状裂纹」,谁来判? |
| 怎么给出位置 | 说一句「中间偏上有条划痕」 | ? —— 要说多准?这个位置能不能直接交给机械臂去处理? |
| 盯两小时之后 | 开始漏、开始走神 | 不会累,但换个场景就乱认(见 05 节的域偏移) |
这就是这一章的分水岭。前三章(颜色、轮廓、二维码)的判断规则是人写的,你能一行行读懂它为什么这么判;从这一章起,判断权交给了一个训练出来的模型 —— 它更准、更通用,但你再也读不到「它凭什么觉得这里是夹杂」。
机器要顶替质检员,光「看清楚」不够,它得同时回答三件事。这三问就是下一节原理的骨架:
① 东西在哪。缺陷可能只有指甲盖大。机器手里只有一堆灰度数,凭什么在整张图里先框出「这一小块要单独看」?
② 框出一堆之后,留哪个?机器不会只给你一个答案:同一处缺陷它会给十几个框,分数还都不一样。凭什么留这个、删那个?
③ 框是在缩小的图上量的,怎么贴回原图?模型只吃固定尺寸的输入,框是在那张标准图上量出来的 —— 换算回你那张原图,凭什么不偏?
先别急着答这三问。第 03 节先把它跑起来,看一眼成品长什么样。
03现象:缺陷套红框:inclusion 0.826
你会看到:一张钢板表面图喂进去,零点几秒就出来了 —— 缺陷处套着红框,框上方标着类别和分数(inclusion 0.83);终端同步打印每条缺陷的类别 + 分数 + 左上右下坐标。
一堆灰度数
等比缩放 + 补边
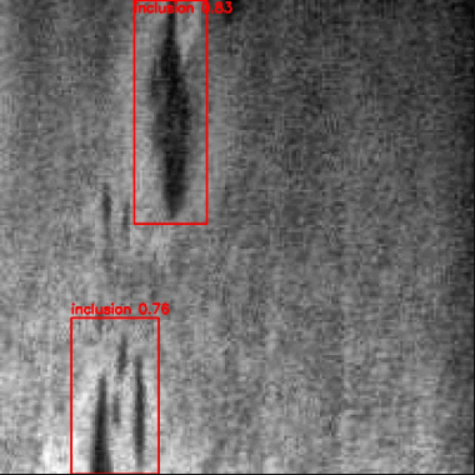
贴在原图坐标上
out1.jpg 上的红框与 inclusion 标签 —— 框在原图坐标系里,说明中间那道缩放被正确地换算了回来。三步跑出这个画面(先照做,每步为什么下一节拆讲):
① 进目录,确认模型和测试图都在。models/ 里放的是转好的 int8 模型,images/ 里是仓库自带的四张缺陷测试图。
cd ~/ros2_ws/src/xflz_eai_car1/vision/01_industrial_defect_detection
ls models/
ls images/
② 单图推理,一次把四张图都跑一遍。--model 指模型,--image 指输入图,--save 让它把带框的结果写盘,四张图的输出分别存成 out1.jpg~out4.jpg。远程 SSH 一定要带 --save:不带的话程序会开窗等你按 q,你在 SSH 里就是「死机」。
python src/app.py --model models/defect_yolov8n_int8.rknn --image images/1.jpg --save out1.jpg
python src/app.py --model models/defect_yolov8n_int8.rknn --image images/2.jpg --save out2.jpg
python src/app.py --model models/defect_yolov8n_int8.rknn --image images/3.jpg --save out3.jpg
python src/app.py --model models/defect_yolov8n_int8.rknn --image images/4.jpg --save out4.jpg
生成的四个文件,打开就是下面四张 —— 四条命令、四类结果:
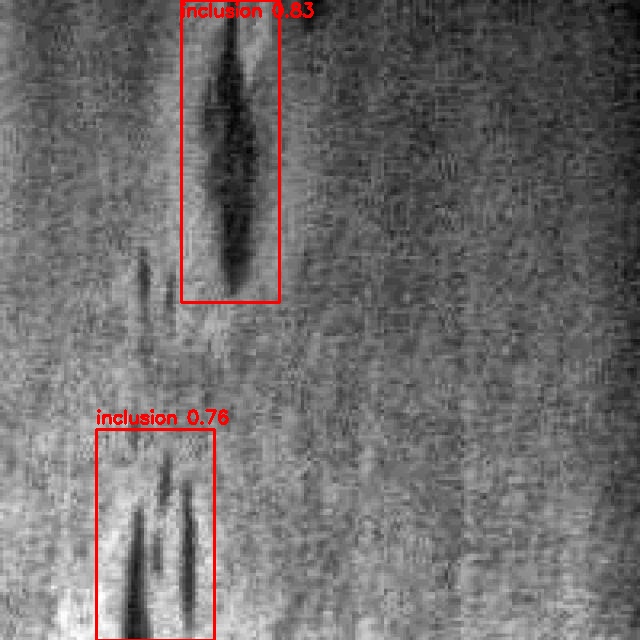
out1.jpg两处夹杂,两个紧框
0.83 / 0.76
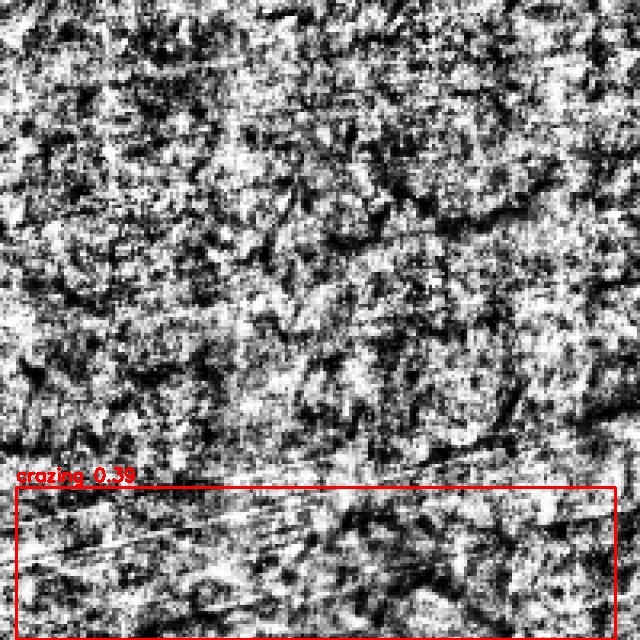
out2.jpg一片网状裂纹
一个大框,0.38
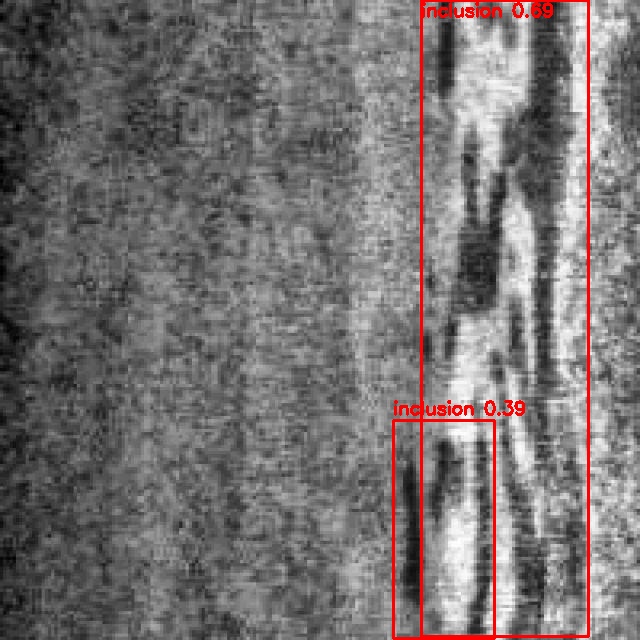
out3.jpg同一条亮带
被报了两次
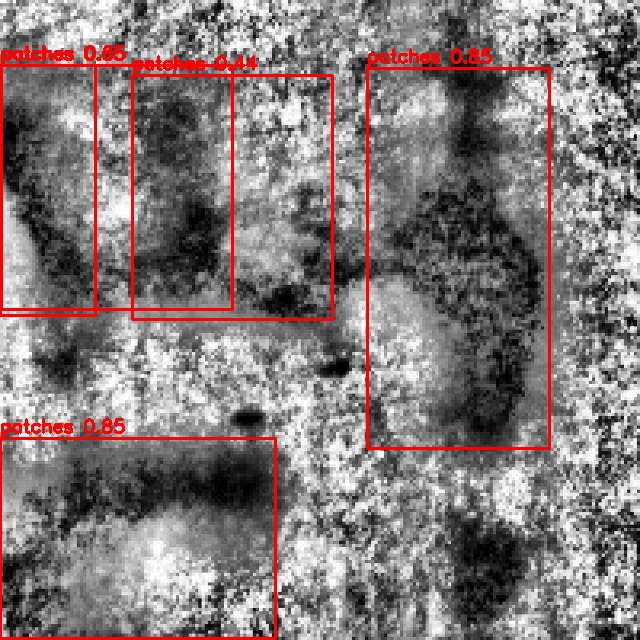
out4.jpg一片斑块
报了五个框
③ 开实时流,让框跟着工件动。要开两个终端:一号窗起相机驱动,二号窗跑 --ros 模式(两个终端的环境变量都要重来一遍,漏了就是互相看不见)。
终端一 · 起相机驱动
source /opt/ros/humble/setup.bash && source ~/ros2_ws/install/setup.bash
export ROS_DOMAIN_ID=N
ros2 launch ascamera hp60c.launch.py
终端二 · 跑实时检测
source /opt/ros/humble/setup.bash && source ~/ros2_ws/install/setup.bash
export ROS_DOMAIN_ID=N
cd ~/ros2_ws/src/xflz_eai_car1/vision/01_industrial_defect_detection
python src/app.py --model models/defect_yolov8n_int8.rknn --ros
然后在同一局域网的浏览器里打开(<板IP> 换成实验板的实际局域网地址):
http://<板IP>:8080/defect.mjpg
🔍 看什么:三样东西要对上 —— ① 框的位置贴不贴缺陷外沿;② 框旁的类别名是不是 crazing / inclusion / patches / pitted_surface / rolled-in_scale / scratches 六种之一;③ 后面的分数(0.83 表示模型有多确定)。这三样正好对应第 02 节的三问,下一节就拆它们的来历。
这就是本实验最终要呈现的现象。此时照做、先看懂它就行;第 05 节会带你走一遍「命令 → 函数 → 文件」的对账,亲手复现同一个画面 —— 跑出来、对得上,实操才算完成。
扩展 · 这四张图各认出了什么,还差哪三类
上面四张图不只是"跑通了",它们刚好把第 02 节那六类里的三类各演了一遍。把终端原文和类别对上,就能看出模型的强弱:
| 输出文件 | 终端原文 | 对应第 02 节 | 这张图说明了什么 |
|---|---|---|---|
out1.jpgimages/1.jpg |
inclusion 0.826 (181,0,279,302)inclusion 0.763 (96,430,214,641) |
夹杂inclusion |
两处互相独立的深色夹杂,各一个框、分数都高。这是「标准成功案例」 |
out2.jpgimages/2.jpg |
crazing 0.385 (17,487,615,640) |
裂纹crazing |
整幅都是网状裂纹,模型只能给一个几乎盖住下半张图的大框,分数只有 0.385 —— 弥漫性缺陷本来就框不住边界 |
out3.jpgimages/3.jpg |
inclusion 0.689 (422,1,589,636)inclusion 0.393 (393,420,495,639) |
夹杂inclusion |
同一处亮带被报了两次(0.39 那个还嵌在 0.69 里面)—— 去重没把它们合成一个 |
out4.jpgimages/4.jpg |
patches 0.848 (-1,439,276,639)patches 0.848 (367,69,550,449)patches 0.648 (-0,65,95,316)patches 0.441 (132,75,332,319)patches 0.348 (1,66,233,309) |
斑块patches |
一片斑块报了五个框,分数从 0.85 一路排到 0.35 —— 框的数量和分数就是这么来的 |
四张测试图覆盖了 夹杂 / 裂纹 / 斑块 三类;第 02 节表里另外三类 —— 麻点 pitted_surface、氧化铁皮压入 rolled-in_scale、划痕 scratches —— 这四张里没有。不是模型不会认,是这四张图上就没有那三种缺陷。想看它们,得自己找图或用自己产线的数据重训(见第 05 节进阶 3)。
其中两张图里藏了两个「后面要用的现象」,先记住:
① 图 3 和图 4 都在同一处缺陷上报了多个框。为什么不是只报一个?这正是第 04 节步骤 3 要解决的事(先按分数筛、再按重叠去重),也是第 06 节那两个滑杆要你亲手拖的东西。
② 图 2 只给了 0.39 分,框还大得离谱。分数低不代表没有缺陷 —— 网状裂纹本来就布满整幅、没有清晰边界,模型只能"框个大概"。这是一条边界:弥漫性缺陷不适合用框来描述,第 08 节会再说它。
04原理:它是怎么找出这些缺陷的
先用人工画好的框教会网络「什么样的纹理算哪类缺陷」,再把学会的模型压成 int8 塞进 NPU —— 这样它才能在板子上一边看图,一边吐出带分数的框。
打个比方:像师傅带徒弟 —— 徒弟先看几百张标好的样板(标注),练到手熟(训练),出门前把心得压缩成一页小抄(量化),上工后扫一眼就能指出「这儿有夹杂,八成把握」(推理)。哪里像:确实是靠「看样板学会的」,没人给它写过一条判断规则;哪里不像:徒弟能解释他为什么觉得像,模型不能 —— 它只给分数,理由读不出来。
这一节分两层。上层:这个模型是怎么来的(标注 → 训练 → 量化,你不必动手,但得知道每一步在干什么,否则「调参」就变成了瞎试);下层:它在板子上怎么做事(四步,这是第 02 节三问的答案)。先看全景,再往下钻。
| 阶段 | 这一步在干什么 | 产物 | 本课要求 |
|---|---|---|---|
| ① 数据标注 | 人工在缺陷图上画框、标类别,把「人的判断」变成机器能读的数字 | labels/*.txt,每行 cls cx cy w h | 知道格式与三条注意事项即可 |
| ② 训练 | 让网络反复看标注图、猜错就调权重,直到能自己猜对 | best.pt + PR 曲线 / 混淆矩阵 | 知道参数怎么给、指标怎么看 |
| ③ 导出 + 量化 | 先转成 ONNX,再压成 int8,让它在 NPU 上跑得动 | best.onnx → …int8.rknn | 知道为什么要压、怎么判断没压坏 |
| ④ 推理 | 板子上把图喂进去,拿到几千个候选框并删到几个 | 三五个框 | 要能说清四步(下面步骤 1~4) |
| ⑤ 输出 | 把框换算回原图坐标,画出来给人看 | 带框的图 + 终端那行字 | 要能解释「形对位漂」 |
标注的框是谁画的?为什么必须这么标
模型不会自己知道「这段纹理叫裂纹」。它知道的全部,就是人给它画过的那些框 —— 标注是唯一的知识来源。一张钢板图上可能有 1 个框,也可能有 5 个,每个框配一个类别名。
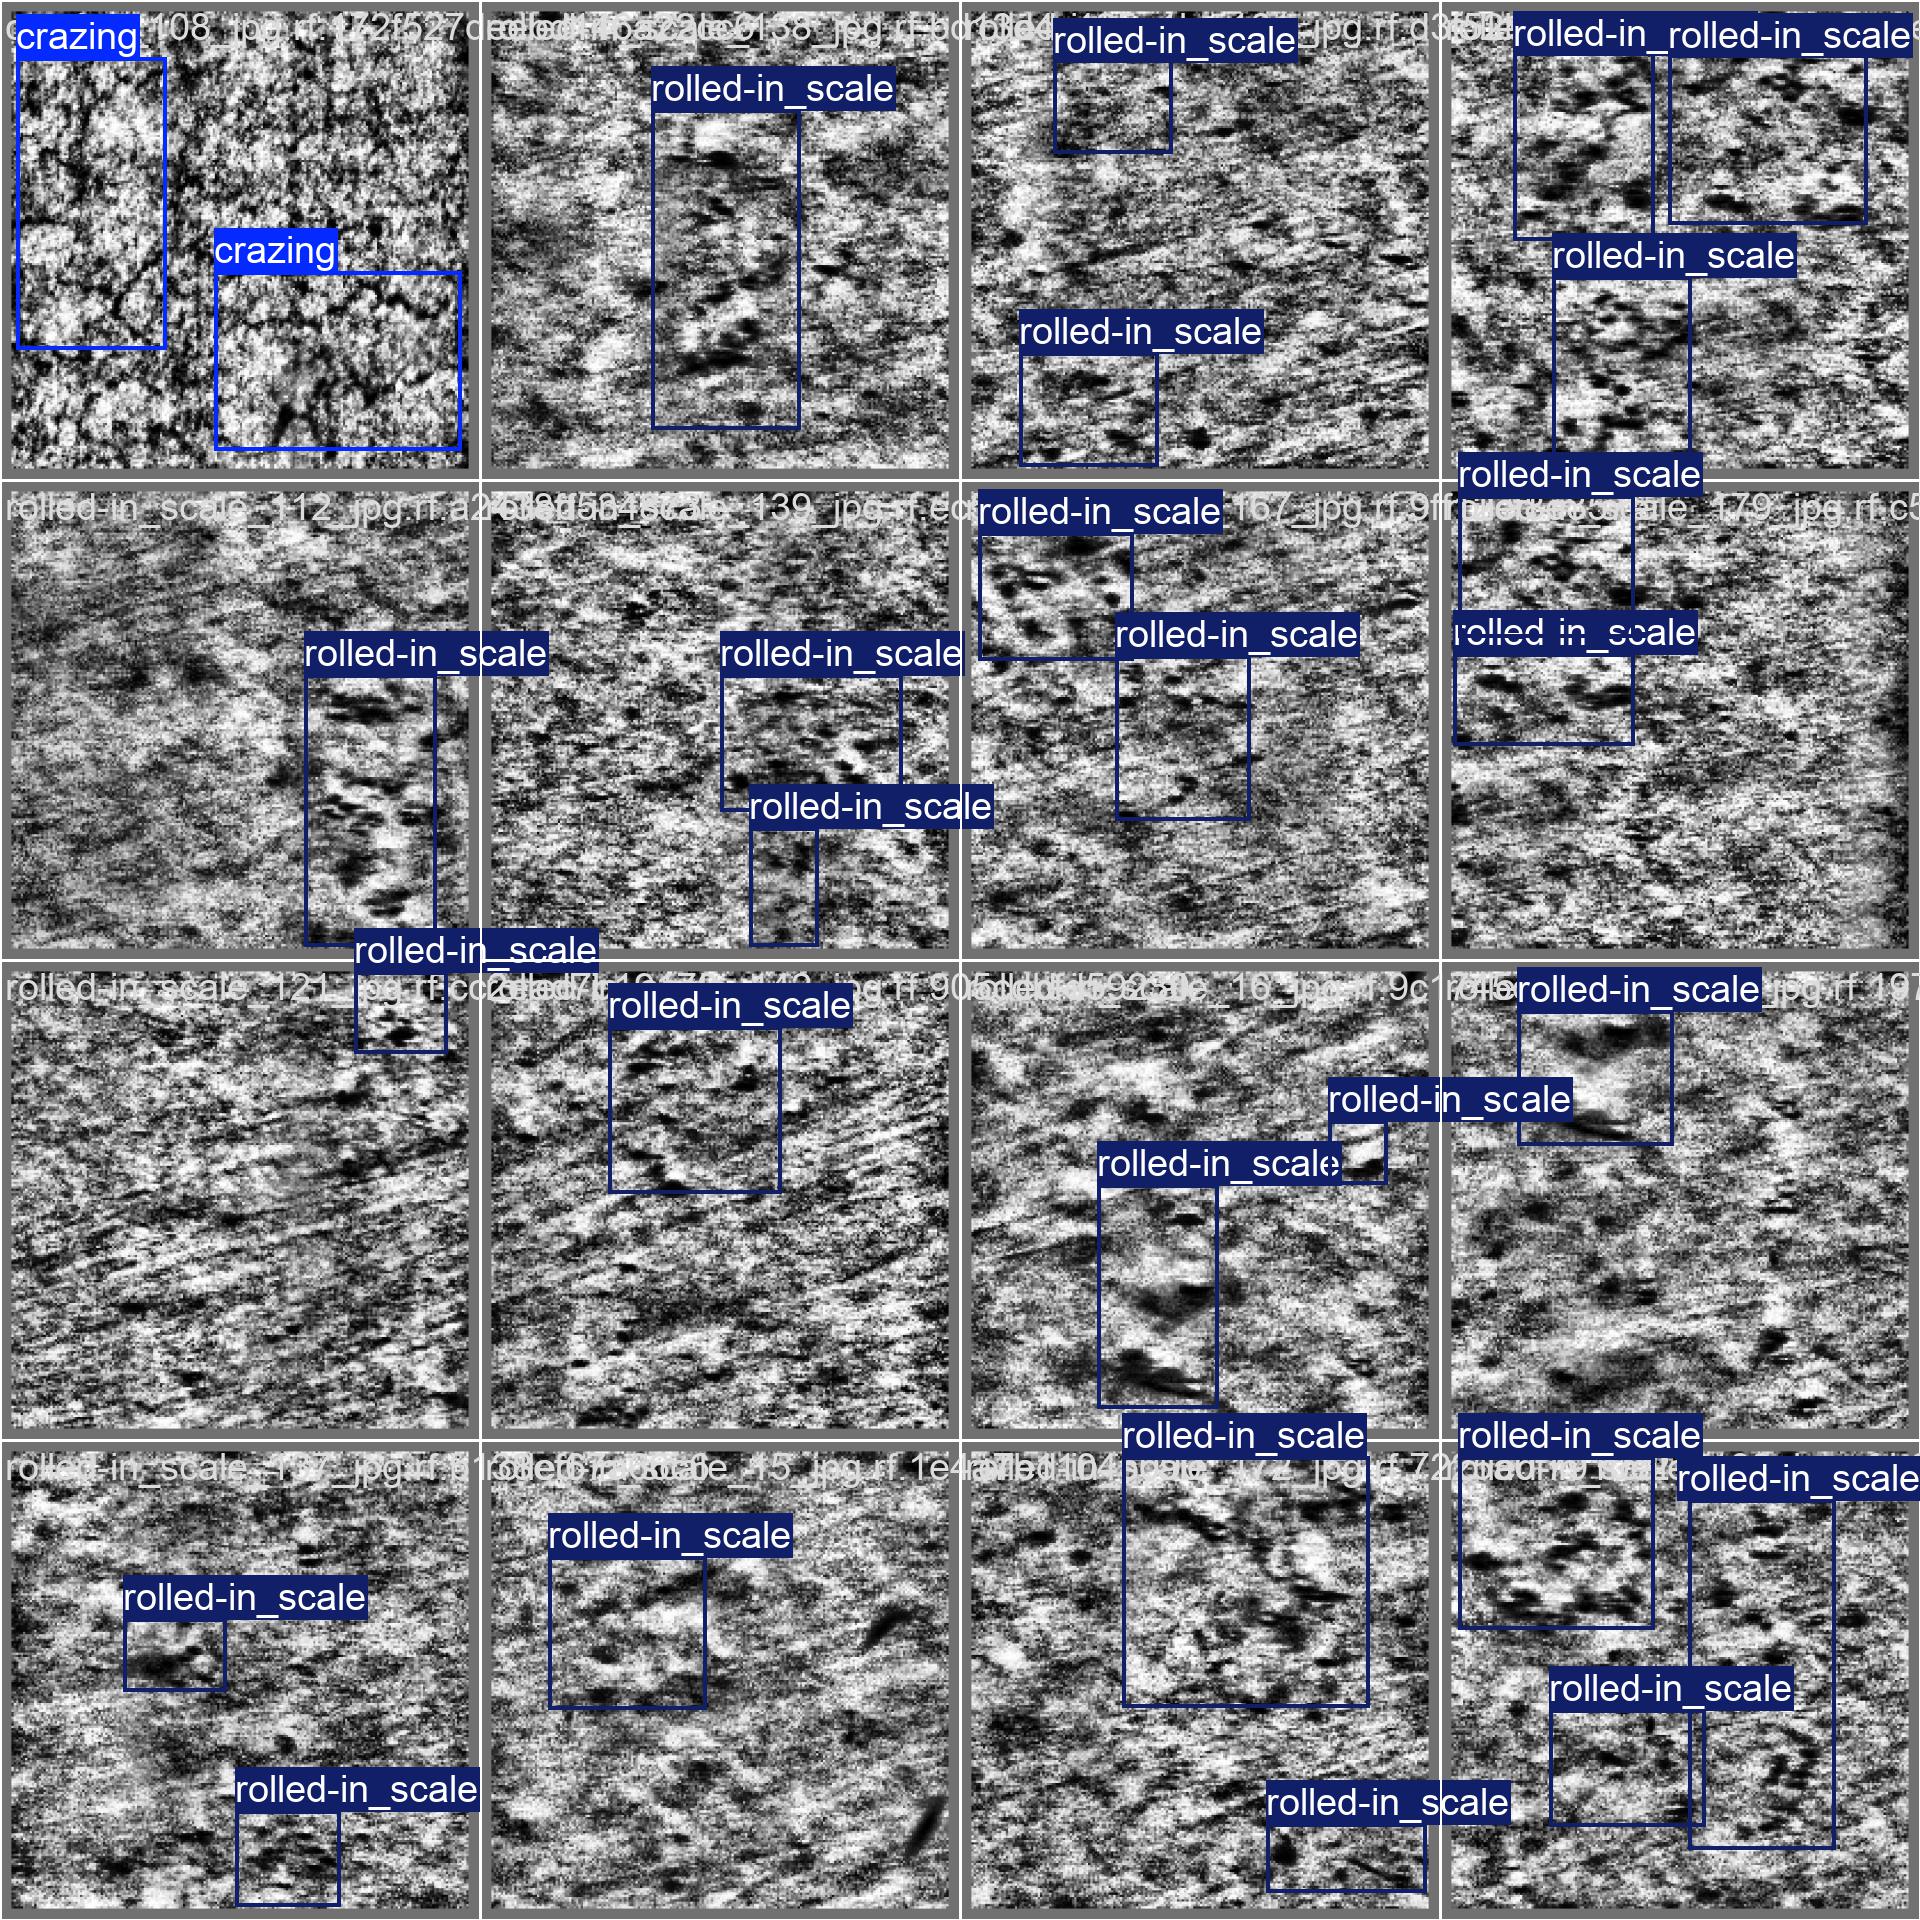
框存进 .txt 时不是像素坐标,而是四个 0~1 的小数:
| 字段 | 含义 | 拿一帧真结果反推一遍 |
|---|---|---|
cls | 类别序号(0 起) | 1 = inclusion(第 2 个类) |
cx cy | 框中心的坐标 ÷ 图宽、图高 | 框 (181,0,279,302) → 中心 (230,151) → 0.3594 0.2359 |
w h | 框的宽、高 ÷ 图宽、图高 | 宽 98、高 302,图是 640×640 → 0.1531 0.4719 |
所以那一行标注就是 1 0.3594 0.2359 0.1531 0.4719。为什么非归一化不可?因为同一批图要缩到 640 再训练、也可能换成别的尺寸推理 —— 用 0~1 表示,换尺寸时不用重算;用像素表示,换尺寸就全错。
src/dataset.py 的 validate_dataset 专门检查这一点。② 框要紧贴缺陷外沿:画松了模型学到的就是「大概这一片」;画紧了遇到同类缺陷又框不住 —— 一致性比精确更重要,同一类缺陷要保持同样的松紧。
③ 类别不能标错,也不能漏:标错的框比不标更糟,模型会把错误当真理学进去。所以工业数据集比通用数据集难标 —— 缺陷小、类间相似(裂纹和划痕就很容易混)。
模型是怎么被教出来的?训练参数给什么、结果怎么看
训练就是反复做一件事:看图 → 猜框和类别 → 跟标注比 → 猜错就调权重,重复 100 轮。参数在 config/defect_config.yaml 的 train 段,也封装在 scripts/train.sh 里。下面是配置内容,不用执行:
train:
  imgsz: 640
  epochs: 100
  batch: 8
  model: yolov8n.pt
| 参数 | 本课取值 | 它在管什么 | 给大了会怎样 |
|---|---|---|---|
imgsz | 640 | 训练输入边长。精度与速度的折中 | 800 也能训,但 640²→800² 计算量增约 56%,板端帧率掉下来 |
epochs | 100 | 把全部图看几遍 | 太少欠拟合(框不准);太多过拟合(训练集好看、新图变差) |
batch | 8 | 一次喂几张图再更新权重 | 显存不够会 OOM;GTX1060 这个级别建议 ≤8 |
model | yolov8n | 用哪个体量的网络(n = nano 最小) | 换 s/m 更准但更慢,板端可能跑不到实时 |
训练完看什么?不是看 loss 降没降,而是看三样:PR 曲线(每类的准召折中)、混淆矩阵(谁被认成了谁)、mAP50(一个总分)。下面两张都是这次训练的真实产物:
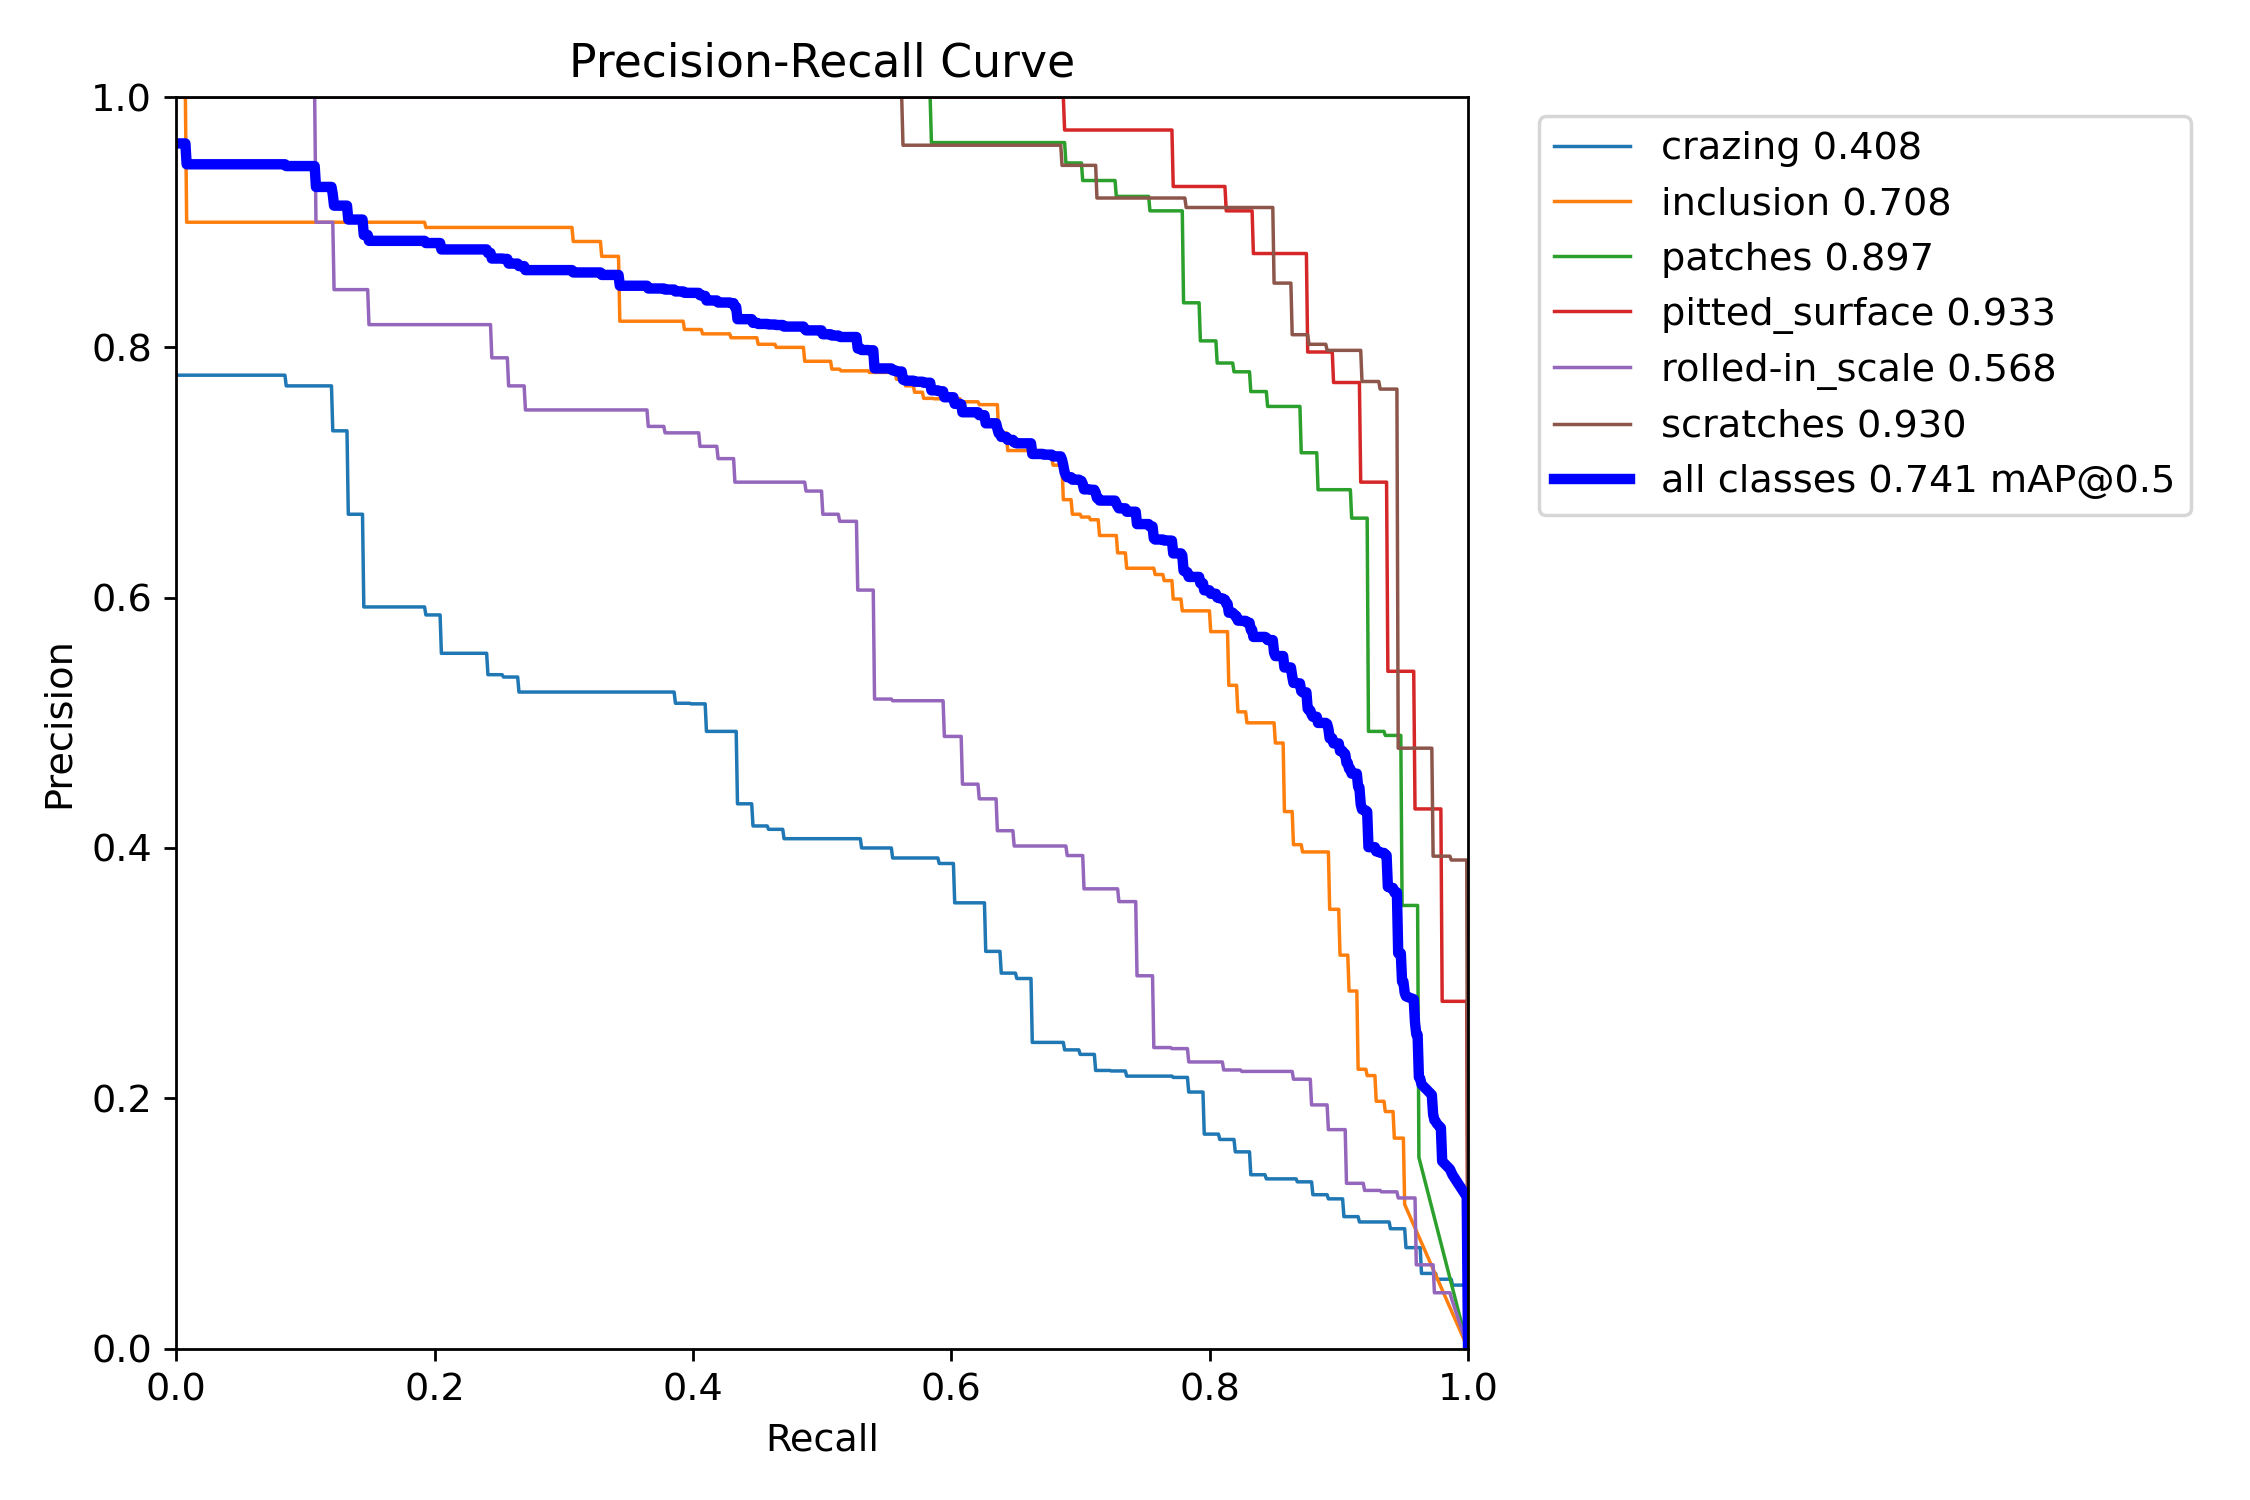
pitted_surface 0.933 最好,crazing 只 0.408 —— 最难的就是网状裂纹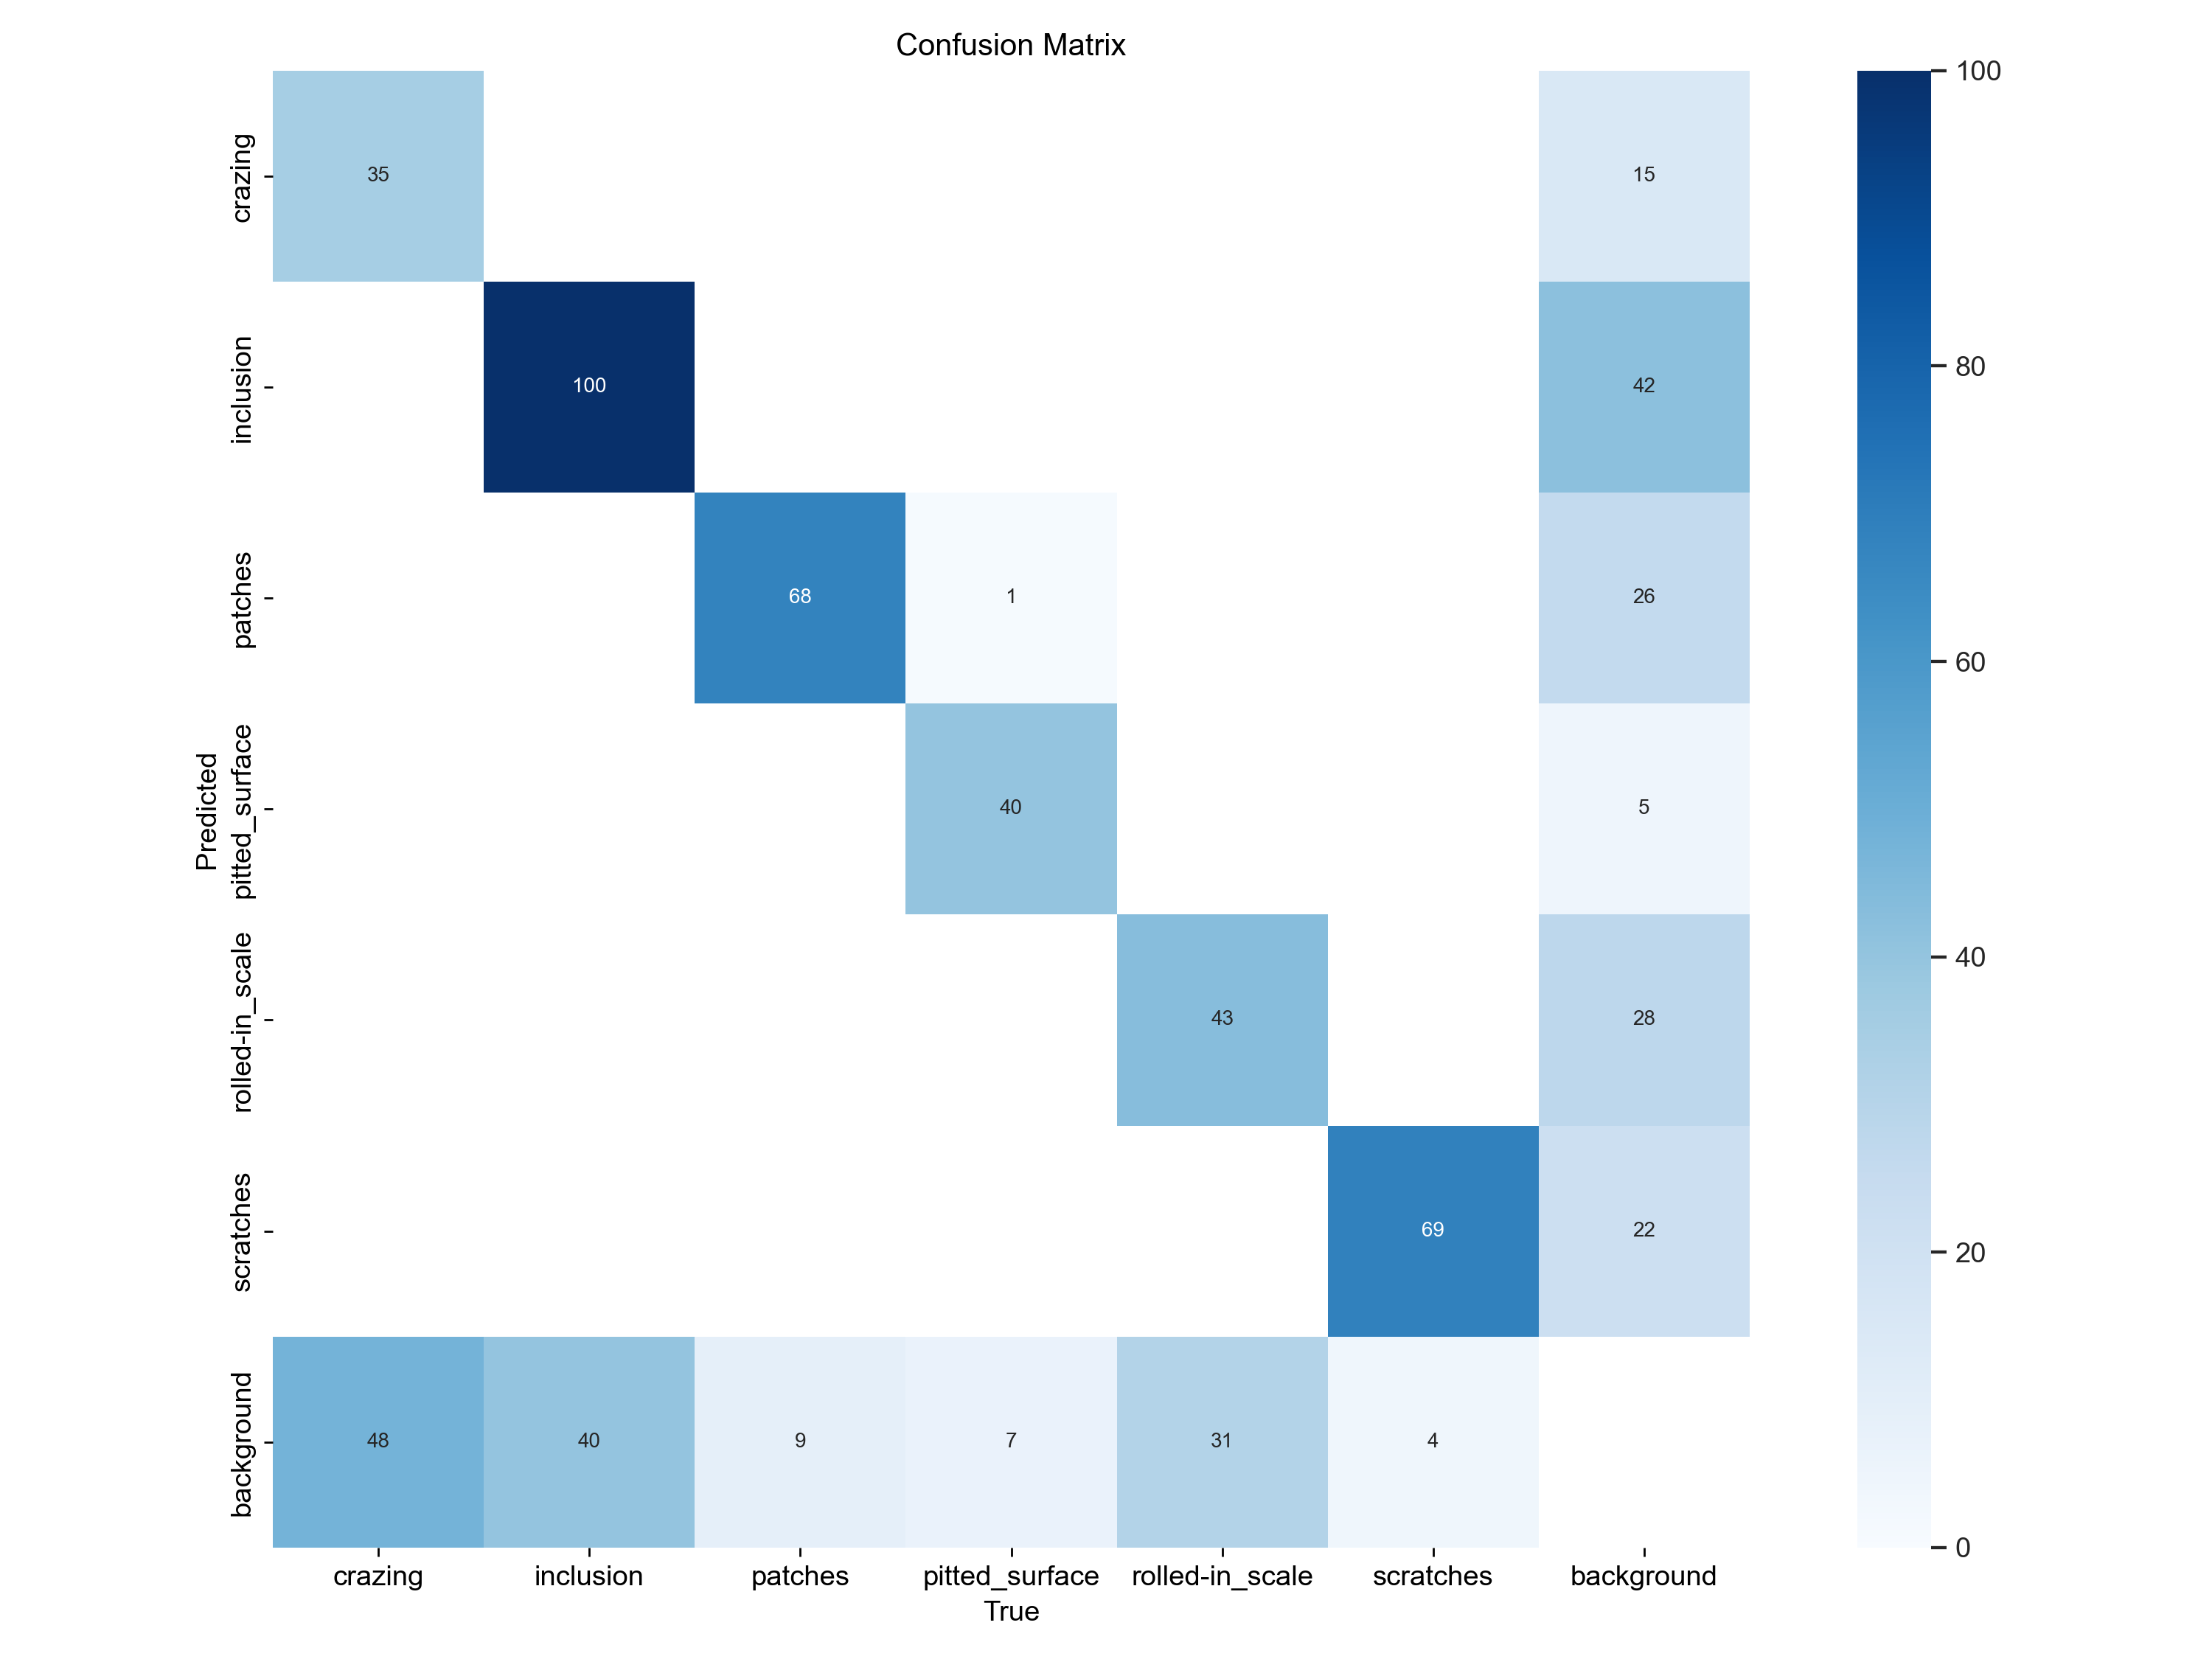
crazing 只认对 35 个、漏掉 48 个;inclusion 100 个全对还记得 out2.jpg 里那片网状裂纹吗?模型只给了 0.385 分、框还盖住半张图。现在知道为什么了:训练侧 crazing 的 AP 只有 0.408、100 个样本漏了 48 个 —— 它不是这一帧没发挥好,是这一类本来就最难。反过来看 inclusion:混淆矩阵里 100 个全对、PR 曲线 AP 0.708,所以 out1.jpg 能给到 0.83。
指标的口径要交代清楚:随仓库交付的权重在 val 集上评到 P=0.657 / R=0.706 / mAP50=0.732;上面 PR 曲线图上印的是 0.741。两个数不必相等 —— 一个是交付权重的评测结果,一个是训练过程里那一轮的曲线,不同轮次、不同划分都会差一点。所以指标永远要连着「哪份权重、哪份数据」一起说。
为什么要压成 int8?压完怎么知道没压坏
为什么要压:训练出来的 best.pt 里每个参数是 32 位浮点。这样的模型在 PC 上跑没问题,但板子上的 NPU 是按 int8 设计的 —— 同样 6TOPS,int8 的吞吐最高。压成 int8 后模型体积、带宽都降到约四分之一,这才跑得出第 03 节看到的 13 FPS。
怎么压:三步,一条命令。yolo export 先把 best.pt 导成 ONNX(9 个输出张量),再让 rknn-toolkit2 在 200 张 val 图上跑一遍定出那把尺子(这一步叫校准),最后落成 .rknn。校准集为什么不能随便找图?因为尺子是照这些图的数值范围定的 —— 拿办公桌的照片去校准,尺子就量不准钢板的数值,模型当场变傻。
怎么知道没压坏:拿同一份 val 数据,分别用 ONNX 和 RKNN 各评一次 mAP50,比差值。工程判据是 掉点 ≤ 3%:
| 比什么 | 怎么量 | 判据 |
|---|---|---|
| 精度掉了多少 | src/eval_map.py 加 --backend onnx / --backend rknn 各跑一次,看两个 mAP50 | 差值 ≤ 3% 算合格(对照基准 0.732,即不低于约 0.702) |
| 掉点超标怎么办 | 先查校准集:是不是用了和真实画面差太远的图、数量够不够 | 加大 --calib-count、校准图改用 val 集;必要时 --no-quantize 先定位是不是量化本身的问题 |
| 模型的物理表现 | 看文件大小与 fps | int8 模型应明显更小、更快;只小不快的,通常不是量化问题而是没走 NPU |
回到板子上:一帧图要走六次形态变化
上面三段是「模型怎么来的」。现在看它在板子上怎么做事 —— 这才是第 02 节三问的答案,也是第 05 节对账表对应的那四步。按第 02 节的三问走:① 东西在哪(步骤 1、2)→ ② 框出一堆,留哪个(步骤 3)→ ③ 怎么贴回原图(步骤 4)。
1640 的方图、RGB 顺序 —— 它凭什么只认这个格式?
先猜一下:把一张 1600×200 的长条钢板照片,直接拉成 640×640 的方图喂进去,行不行?
不行。网络学的是「这个形状像划痕」,一拉,细长的划痕就被横向压扁了 —— 形状一变它就不认识了。所以做法是等比缩放:按两条边里更「挤」的那条算比例,缩完把空出来的地方补上,凑满 640 的方框。这套动作叫 letterbox。
1600×200 → 横向压到 1/2.5、纵向拉 3.2 倍。
一道细长划痕变成一条胖带子,网络认不出来。
scale = min(640/h, 640/w) = 0.4 → 缩放后 640×80,上下各补 280 像素。
划痕还是那道细长划痕。
补边用的颜色也不是随便填的 —— 配置里 pad_color: [0, 0, 0] 是纯黑。为什么不是训练时常用的 114 灰?因为这块板子上的模型是 int8 量化的:填充值会真的进卷积计算,填充值一变,边缘那圈特征的分布就跟着偏,框就整体错位。转换、校准、推理三处的填充值必须是同一个数。
还有两个「必须」,答案都在转换脚本里那几行:
下面是 src/convert_rknn.py 里 rknn.config(...) 的节选(已省略中间几行参数),这是源码片段,不用执行:
rknn.config(
    mean_values=[[0, 0, 0]], std_values=[[255, 255, 255]],   # 归一化在这里做,Python 侧不要再除 255
    quant_img_RGB2BGR=False,                                 # 输入已为 RGB,别再转一次色域
    target_platform=target, single_core_mode=True, model_pruning=True,
)
为什么必须 RGB:quant_img_RGB2BGR=False 表示转换器不做通道交换 —— 因为导出模型时输入约定就是 RGB。所以推理侧必须先 to_rgb() 把 OpenCV 读进来的 BGR 换成 RGB。两侧约定不一致的典型症状是「框的位置对、类别全错、分数普遍很低」 —— 形状信息还在,颜色信息全乱了。
为什么不能自己除 255:std_values=[[255,255,255]] 说明这个归一化是 RKNN 运行时内部做的。你在 Python 里再除一次,输入就被压到 0~1,而模型以为收到的是 0~255 —— 分数会整体塌掉。
2几万个像素里,它凭什么先找到「这儿有东西」?
先猜一下:它是不是先找边缘、再把边缘连成块,像第 02 节的多边形轮廓那样?
不是。它不做任何显式的「找边缘」。它把 640 的图切三种粗细的格子:80×80、40×40、20×20,总共 80²+40²+20² = 8400 个位置;每个位置都自己报一个答案 ——「我这块里有个东西,中心在这儿、宽高这么大」,外加一个「我有多确定」。
为什么要三种粗细?因为缺陷的尺度差得远:麻点只有几十个像素,20×20 的格子根本盖不住它;一整片斑块可能占半张图,80×80 的细格子又「看不全」。三个尺度各管一段。
每个位置报出来的数,就是图里那 9 个张量(3 个尺度 × 3 个张量):
| 张量 | 形状 | 装的是什么 |
|---|---|---|
box | (1, 64, h, w) | 框的原始分布:4 条边 × 16 个 bin。不是直接给偏移量,而是给 16 个格子的概率 |
cls | (1, 6, h, w) | 6 类缺陷各自的分数(已经过 sigmoid) |
cls_sum | (1, 1, h, w) | 分数之和,可忽略的分支 |
为什么框要给「16 个 bin 的概率」这么绕?这叫 DFL:与其让网络猜一个精确数字,不如让它对 16 个候选值各表个态,再按概率加权求和 —— dfl_decode() 干的就是这件事。好处是边界模糊的目标(细纹理、麻点)也能给出连续、稳定的框,而不是在两个整数之间来回跳。
这段「16 bin 加权」是留在 CPU 上算的,不放进模型图里。原因很实际:RKNN 转换器对动态索引、切片拼合这类算子支持得不好,硬塞进去要么转不过去、要么效率很低。
3同一处缺陷被圈了十几次,凭什么只留一个?
先猜一下:8400 个位置各报一个框,其中真正压在这处缺陷上的大概有多少个?
好几十个。所以解码完你手里是几千个框,绝大部分是垃圾。清理分两步,顺序不能反:
第一步,按分数卡一刀。分数低于 score_thr(默认 0.25)的框直接丢掉。这一步便宜、粗暴,先把大头去掉。
第二步,按重叠去重。两个框重叠多少,用 IoU 量:完全重合是 1,完全不沾是 0。做法是逐类做 NMS —— 同一类里按分数排队,最高的留下,跟它 IoU 超过 iou_thr(默认 0.45)的同类框全删掉。
为什么强调「逐类」?因为不同类的框允许重叠:一片 patches 里完全可能套着一条 scratches。如果跨类一起去重,两个真缺陷会被合成一个,而且你还看不出是哪里丢的。
这两个参数一动,画面立刻变脸 —— 这也是第 06 节要你亲手拖的东西:iou_thr 调到 0.30,挨得近的两处真缺陷(比如两条平行划痕)会被当成同一个,只剩一个框;调到 0.70,同一处缺陷又会冒出两三个重复框。
4框是在小图上量的,怎么贴回原图还对得准?
先猜一下:既然只是缩了个比例,把坐标乘回去是不是就完事了?
差一步。缩放之前还补了边,补边把内容整体推到了画面中间,所以换算得先「减掉补边」再「除比例」:
原图坐标 = (640 图上的坐标 − pad) ÷ scale
拿一张 1600×200 的图算一遍:scale = min(640/200, 640/1600) = 0.4,缩放后是 640×80,上下各补 pad_y = (640−80)/2 = 280。假设模型在 640 图上给出 y1 = 300,那么原图上 y1 = (300 − 280) ÷ 0.4 = 50。
如果忘了减那 280 呢?算出来是 300 ÷ 0.4 = 750,比正确答案大了 700 像素。而且所有框会朝同一个方向、偏同样的距离 —— 这种「系统性平移」一眼就能认出来,它是本实验第一大坑。
draw() 后面用 cv2.rectangle 画的。所以画面上「框错了」有两种可能:模型算错了,或者我们画的时候坐标换错了。先分清这两件事,排查能省一半时间 —— 形状对、位置整体漂,基本都是后者。
这四步在代码里分别是谁
这张表只看第三列和第五列就够了 —— 左两列是「哪一步、屏幕上看到什么」,右两列是「谁在干、动了会怎样」。
| 步 | 画面/数据变成了什么 | 谁在干(函数 · 文件) | 关键参数 | 动了会怎样 |
|---|---|---|---|---|
| 步骤 1 ①② |
任意尺寸的图 → 640×640 的方图,空出来的地方补黑边,形状一点不变 | letterbox()to_rgb()( src/preprocess.py) |
infer.imgsz: 640infer.pad_color: [0,0,0] |
填充值改成 114(训练默认)→ 与量化时不一致,框整体偏移;不补边直接拉伸 → 细长划痕被压扁,直接漏检 |
| 步骤 1 ② |
方图 → 4 维数组 (1,640,640,3),通道从 BGR 换成 RGB |
np.newaxis(补维)( src/infer.py) |
无,写死在代码里 | 漏掉换通道 → 位置对、类别全错、分数普遍很低;自己再除 255 → 分数整体塌陷 |
| 步骤 2 ③ |
640 的图 → 9 个原始张量:80/40/20 三个尺度各出 3 个 | RKNNLite.inference()( src/infer.py) |
rknn.target_platform: rk3576(转换期定死) |
输入漏成 3 维 → 报 need 4dims input;换官方 ultralytics 导的 ONNX(不是 9 输出)→ 解码对不上 |
| 步骤 2 ④ |
9 个张量 → 几千个候选框,同一处缺陷被圈十几次 | dfl_decode() · box_process()( src/postprocess.py) |
无(16 bin 与 stride 固定) | 跳过 DFL 直接取整 → 细纹理缺陷的框会抖、会缩,边缘糊的目标框不准 |
| 步骤 3 ⑤ |
几千个 → 三五个,一处缺陷一个框 | decode_rknn() · classwise_nms()( src/postprocess.py) |
infer.score_thr: 0.25infer.iou_thr: 0.45 |
score_thr 调到 0.60 → 细小划痕成片消失(漏检↑);iou_thr 调到 0.30 → 挨得近的两处真缺陷被合成一个 |
| 步骤 4 ⑥ |
框换回原图坐标,画上红框与 inclusion 0.826 |
unletterbox()(src/preprocess.py)draw()(src/app.py) |
无(pad 与 scale 由 letterbox 带回) | 少减 pad → 系统性平移(1600×200 的图上会漂 700 像素);pad 加减反了 → 往反方向漂 |
先认识 6 个词
这六个词后面每一步都会出现,花两分钟认全,之后就不用反复查了。前三个属于「模型怎么来的」,后三个属于「它在板子上怎么做事」。
把框写成四个 0~1 的小数(中心 x/y + 宽高),而不是像素。为什么需要:同一批图要缩到 640 训练、也可能换尺寸推理,用比例表示就不用重算。什么时候出问题:混进像素坐标,训练会崩或 mAP 趋近 0。
把每类的 PR 曲线下的面积(AP)平均起来,一个总分。为什么需要:单看准确率会被"什么都不报"骗过去。什么时候不可比:不同数据集、不同划分算出来的 mAP 不能横着比。
量化时用来"定尺子"的一批真实图(本课 200 张 val)。为什么需要:int8 的取值格子按这批图的数值范围来切。什么时候失效:校准图与真实画面差太远,尺子就量偏,掉点会超标。
模型有多确定「这里是划痕」,0.83 表示它挺有把握。用来排序和筛选。什么时候不可信:这只是模型自己的把握,不等于真的对 —— 对着桌面拍,它照样理直气壮地乱圈。
两个框重叠了多少:交集面积 ÷ 并集面积,完全重合是 1。NMS 删谁全靠它。什么时候失灵:两处真缺陷挨得很近时,它们之间的 IoU 也很高,会被当成同一个。
按分数排队,留最高的,把跟它 IoU 超阈值的同类框删掉。为什么需要:8400 个位置各报一个框,不去重没人看得懂。什么时候失效:它只删同类框 —— 所以跨类重叠是允许的,这正是「逐类」的意义。
等比缩放到目标尺寸,空出来的地方补边,保证形状不变。为什么需要:直接拉伸会让网络认不出被压扁的目标。什么时候出错:填充值或补边量与转换、校准两侧不一致,框就整体漂。
YOLOv8 这个名字是什么意思,9 个输出又是怎么来的选读 2 分钟
YOLO 是 "You Only Look Once",只看一眼。早期做检测要在同一张图上扫很多遍,YOLO 只看一遍就能给出所有框 —— 所以它快,能实时。
v8 是第八代,n 是 nano,最小号。这次用的 yolov8n 参数最少、最快,之所以选它,就是因为要在板子的 NPU 上跑到实时。
相对上一代,它的关键变化是四点:去掉预置锚框(anchor-free,中心点落在哪个格子就由哪个格子负责)、C2f 模块替代 C3、分类与回归解耦成两个分支、以及用 DFL 做框回归。主干 CSPDarknet 出 80/40/20 三个尺度的特征图,PAN-FPN 把它们融合,所以最后是 3 个检测层 × 3 个张量 = 9 个输出。
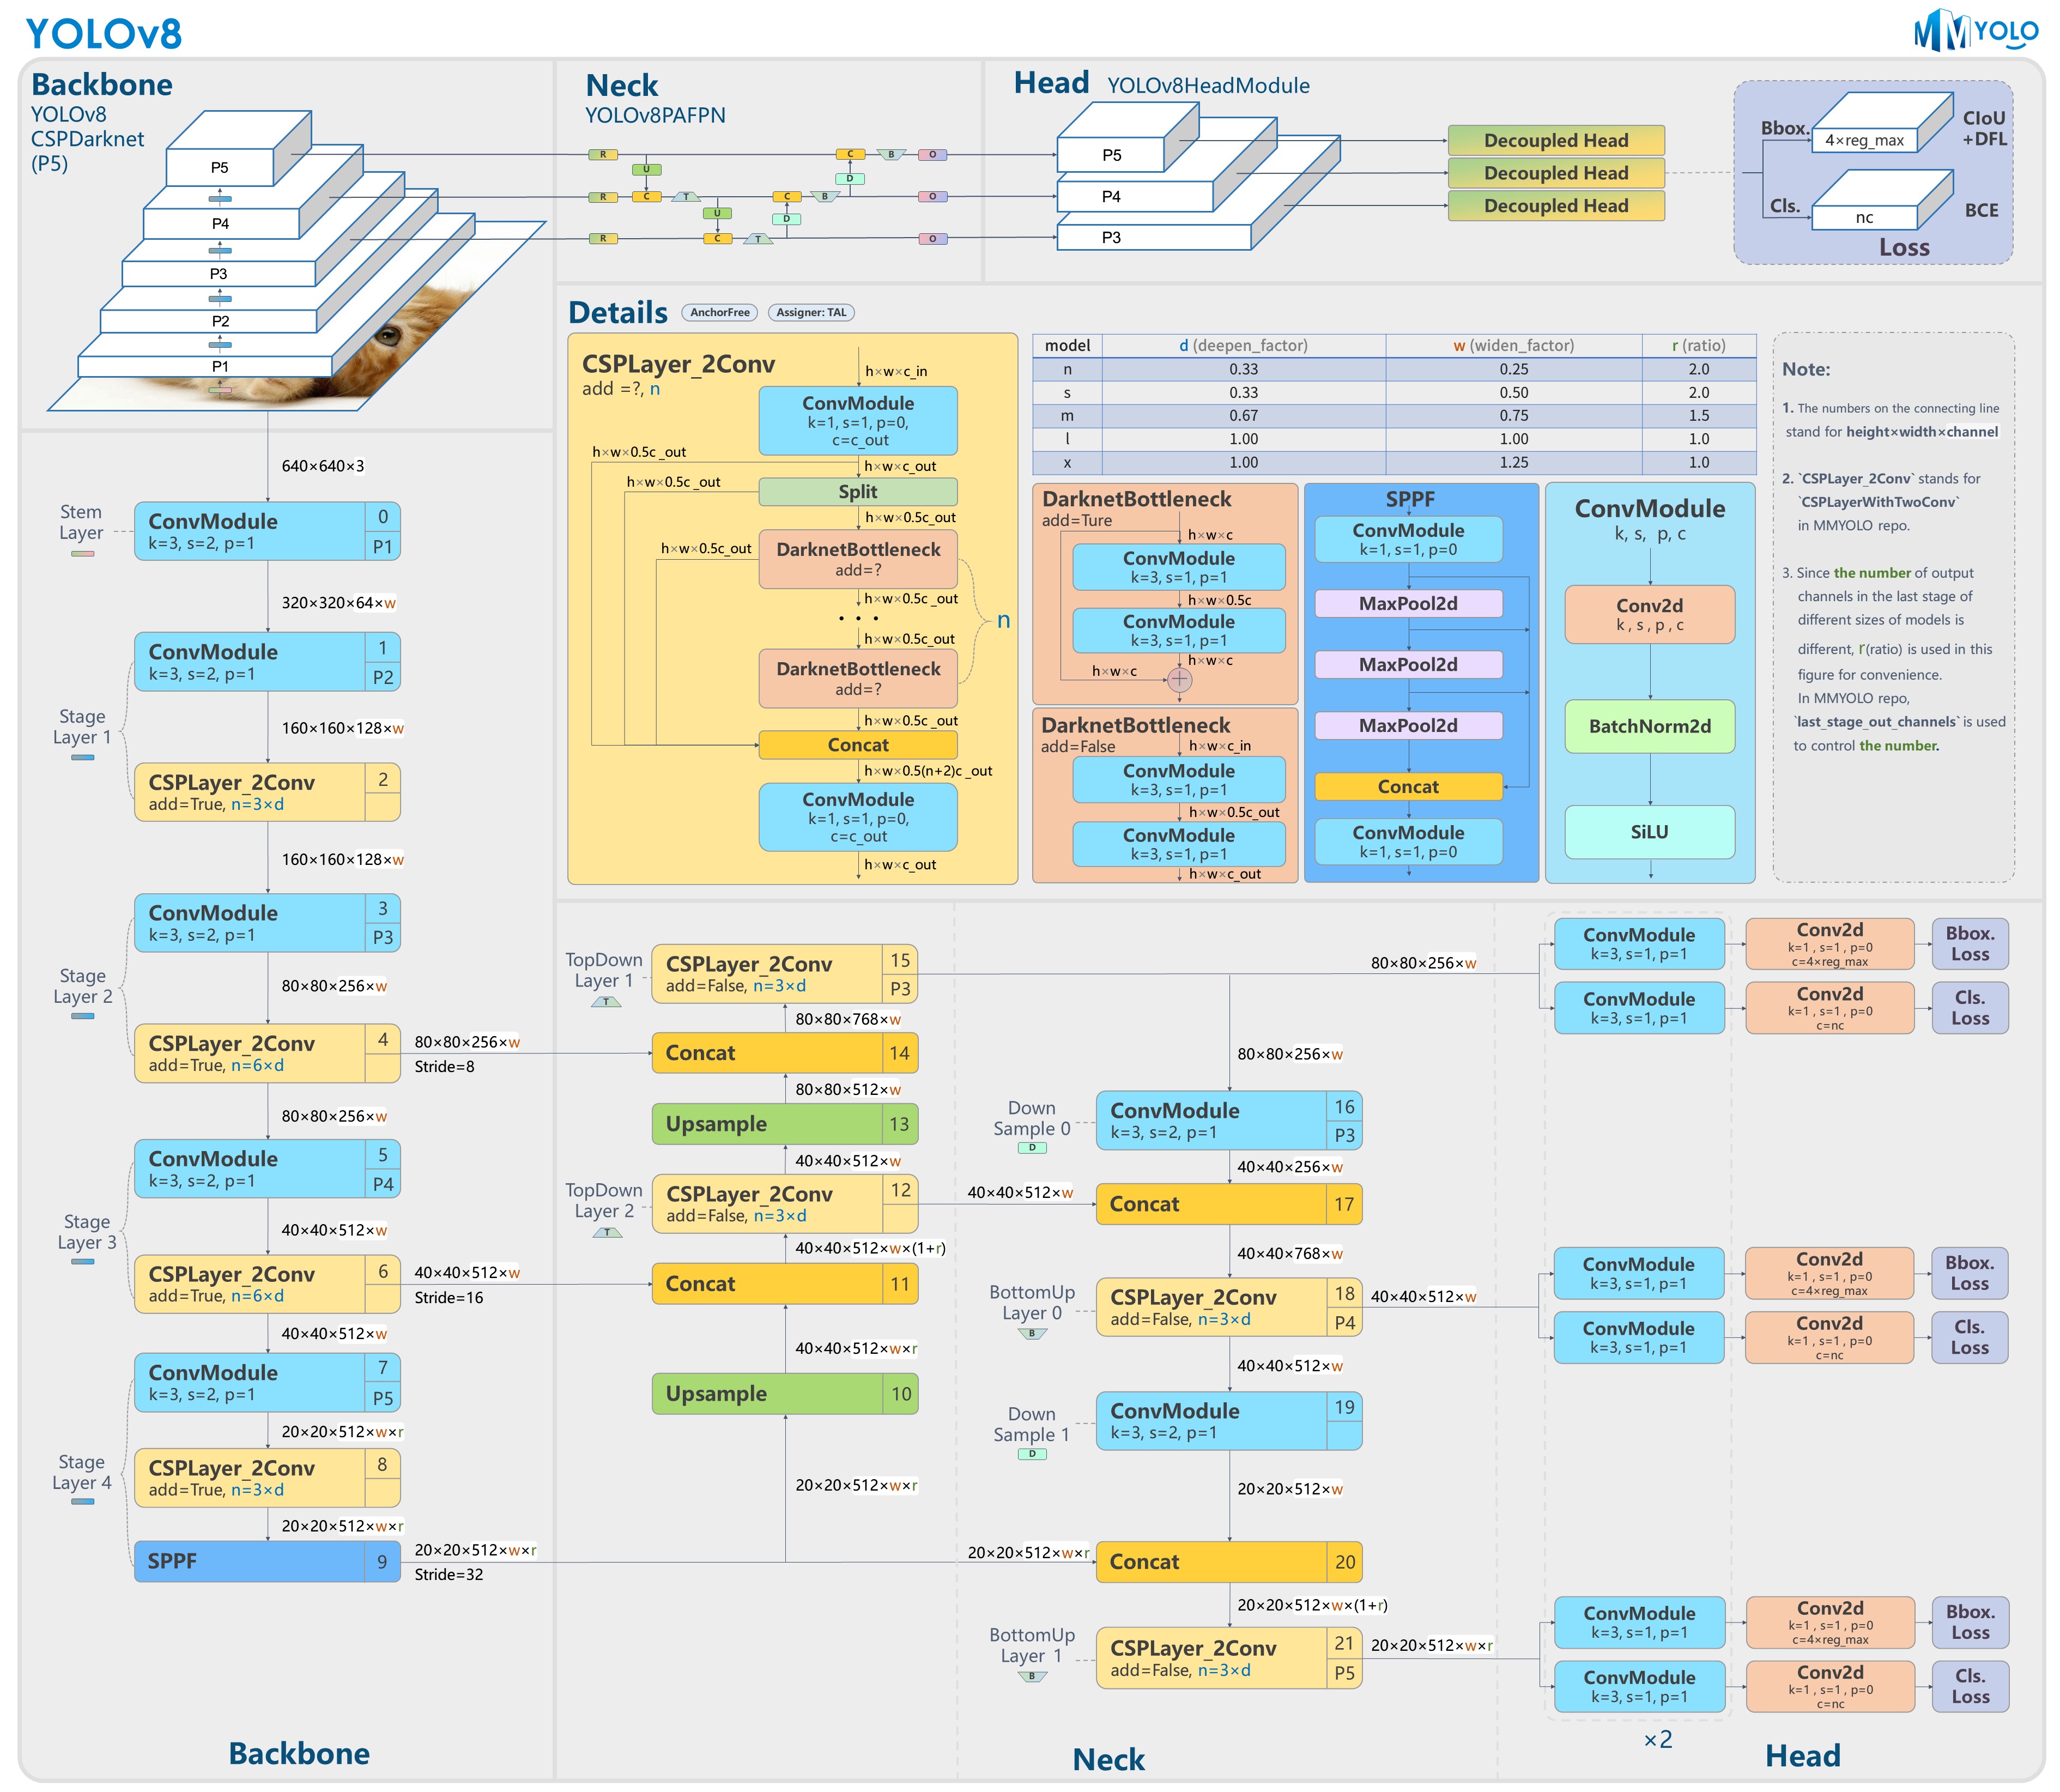
这张图不影响你跑通、也不影响你调参。等你哪天要自己训模型、或者要换更小的模型时,再回来细看。
这套方法什么时候不管用选读 1 分钟,决定你能不能当手册用
什么时候会失效,怎么救:
- 换光照、换材质、换产线:模型的判断是从训练数据里长出来的,照明一变,同一处缺陷的像素分布就变了。救法是用新场景的数据重训,没有别的捷径 —— 调阈值不行,这不是阈值问题。
- 缺陷小到只有十几个像素:20×20 那层的格子一个就覆盖 32 个原图像素,太小的目标在特征图上直接消失。救法是提高
imgsz(代价是 FPS 掉)或者把大图切块分别检测。 - int8 量化后掉点超过 3%:先看校准集。校准图必须贴近真实产线画面 —— 用错场景的图去校准,等于拿错尺子量。加大
--calib-count或改用 val 集作校准。 - 两个缺陷贴得极近:逐类 NMS 会把它们合成一个。这是 NMS 的固有代价,只能调
iou_thr折中。
现在回头看第 02 节那张图:中间那几道深色竖纹之所以能被框住、还标对了 inclusion,走的就是这四步 —— 先把长条图等比缩进 640 的方框(步骤 1),让网络在 8400 个位置上各报一个框(步骤 2),按分数卡一刀、再按 IoU 去重(步骤 3),最后把四个数减掉补边、除以比例,换算回原图(步骤 4)。第 02 节的三个问号,到这里都填上了。
05实操:单图、实时、换后端三条命令
全部在板子上执行。三个步骤从简单到复杂,复制、粘贴、回车就行。每条命令后面都标了「跑完看到什么算对」。
-
进目录,先确认环境没坏约 3 分钟
先站到正确的位置,跑一遍单元测试确认依赖齐了(仓库自带 42 个用例;没有数据集的机器上,数据集那几条会自动跳过),再看一眼推理段的关键参数。
cd ~/ros2_ws/src/xflz_eai_car1/vision/01_industrial_defect_detection
python -m pytest -v
42 passed ← 全绿就说明 OpenCV / numpy / rknnlite 都到位了然后用一条命令把
infer段读出来 —— 这四个数是本章最常改的东西:PYTHONPATH=./src python -c "from config import load_config; cfg = load_config('config/defect_config.yaml'); print(cfg['infer'])"
{'imgsz': 640, 'score_thr': 0.25, 'iou_thr': 0.45, 'pad_color': [0, 0, 0]}配置加载带契约式校验:
infer段缺了某个键,加载时就直接抛ConfigError,而不是等推理时静默出错。想亲眼看看,把 yaml 里的infer段整段删掉再跑一次这条命令就知道了。 -
单图推理,先看到红框约 10 秒
--model指模型文件,--image指输入图,--save把带框结果写盘。第一次跑会看到一行note: NEU-DET data.yaml 不在本机,使用内置 6 类名—— 板上没有训练数据集,程序内置了这 6 个类名兜底,属正常现象。python src/app.py --model models/defect_yolov8n_int8.rknn --image images/1.jpg --save out1.jpg
fps=15.6 inclusion 0.826 (181,0,279,302) inclusion 0.763 (96,430,214,641) saved -> out1.jpg终端每一行就是一处缺陷:类别 + 分数 + 左上右下坐标。打开
out1.jpg,红框应该贴着缺陷外沿。另外三张图跑出来有什么区别,第 03 节的扩展块里已经逐条列过。接着把同一个文件换成
.onnx跑一次 —— 程序按扩展名自动切后端:.rknn走 NPU,.onnx走 CPU。这一步是第 7 条命令,也是下一节进阶的入口。python src/app.py --model train/weights/best.onnx --image images/1.jpg --save out_onnx.jpg
saved -> out_onnx.jpg ← 同一张图、同样的框,但 fps 明显掉下来(具体多少看你机器的 CPU) -
开实时流,让框跟着工件动约 5 分钟
要开两个终端。
source两句把 ROS2 系统环境与本工作区环境装进当前终端,缺任何一条都找不到相机包;export ROS_DOMAIN_ID=N把节点通信频道拨到 N(0~101 任选一个,每台设备各选各的,别都设成同一个值)。终端一 · 起相机驱动
source /opt/ros/humble/setup.bash && source ~/ros2_ws/install/setup.bash
export ROS_DOMAIN_ID=N
ros2 launch ascamera hp60c.launch.py
日志持续滚动,无 ERROR / 无红字二号窗跑检测。source 两句和 DOMAIN_ID 都要重来一遍 —— 这是新手最容易漏的地方,漏了就是两边互相看不见,程序一直等首帧。
终端二 · 跑实时检测
source /opt/ros/humble/setup.bash && source ~/ros2_ws/install/setup.bash
export ROS_DOMAIN_ID=N
cd ~/ros2_ws/src/xflz_eai_car1/vision/01_industrial_defect_detection
python src/app.py --model models/defect_yolov8n_int8.rknn --ros
frame 30 avg_fps=13.2 frame 60 avg_fps=13.0 ← 每 30 帧打一次平均帧率,板端稳定在 13 FPS 上下同一局域网内用浏览器打开下面这个地址(
<板IP>换成板子的局域网地址,不是 127.0.0.1):http://<板IP>:8080/defect.mjpg
浏览器里出现滚动画面,把带缺陷的样板在镜头前慢慢移动,红框跟着一起动13 FPS 是这块板子的真实水平:一个在 PC 上训出来的模型,被压成 int8、塞进 6TOPS 的 NPU,还能一秒看 13 帧 —— 这已经够实时了。
out1.jpg 已存盘。两处对上了,说明代码框架、流程、步骤你已完整走通。
命令 → 函数 → 文件:你敲的每一行到底经过了谁
跑通之后要能回答一个问题:这个参数属于链上哪一段,改它会影响哪一格的画面?下面这张表就是这段链条的「户口本」,四个步骤里的每个函数都能在这里找到出处。
| 命令 / 参数 | 经过的函数(文件) | 产出 / 影响链上哪一段 |
|---|---|---|
--model ….rknn | _make_backend()(src/app.py)→ RKNNBackend(src/infer.py) | 选后端:.rknn 走 NPU,.onnx 自动落到 CPU 后端 —— 决定步骤 2 那格的执行位置 |
--image / --video / --camera / --ros | run_frame()(src/app.py);--ros 走 Ros2Camera.read()(src/ros2_source.py) | 决定第一步「原图」从哪来。--ros 时帧来自话题 /ascamera_hp60c/camera_publisher/rgb0/image |
--save out1.jpg | draw()(src/app.py)→ 写盘 | 步骤 4 之后那一步:把框真正画到像素上。不带它就会开窗等你按 q |
infer.imgsz: 640 | letterbox()(src/preprocess.py) | 步骤 1:缩放比例与补边量都由它算出来。改了它,训练时的 imgsz 也必须跟着改 |
infer.pad_color: [0,0,0] | letterbox()(src/preprocess.py) | 步骤 1 的补边值,同时参与步骤 4 的反换算。改成 114 → 边缘特征分布偏移,框整体错位 |
infer.score_thr: 0.25 | decode_rknn()(src/postprocess.py) | 步骤 3 第一刀:低于它的框直接丢。往低调捡回弱小缺陷也带回假框,往高调反过来 |
infer.iou_thr: 0.45 | classwise_nms()(src/postprocess.py) | 步骤 3 第二刀:同类框重叠超过它就删。调到 0.30,挨得近的两处真缺陷被合成一个 |
| (写死在代码里,无参数) | to_rgb()、np.newaxis(src/preprocess.py / src/infer.py) | 步骤 1 尾段:换通道顺序、补第 4 维。这两步没法用配置关掉 |
| (写死在代码里,无参数) | dfl_decode()、box_process()(src/postprocess.py) | 步骤 2 尾段:把 9 个张量解成候选框 |
| (写死在代码里,无参数) | unletterbox()(src/preprocess.py) | 步骤 4:减 pad、除 scale,换回原图坐标 |
看不到的环节也要交代清楚:NPU 内部那 9 个张量是怎么算出来的,源码里是看不到的 —— 那是 .rknn 模型里的指令,我们只能拿到它的输出。所以步骤 2 的前半段在这个仓库里没有对应函数,别去找。
你该看到的画面
知道「正常」长什么样,才知道「异常」是哪一处出的问题。
红框贴着缺陷的边界,框上方一行 inclusion 0.83。数字与终端打印的那三件套一致。
移动工件时框一起动、不闪。抖动明显多半是画面太暗或离焦,不是模型坏了。
这是正常的。模型只认识钢板上的六类缺陷,遇到没学过的画面会硬套 —— 这叫域偏移,不是 bug。
重点与易错点
按「我看到的症状」找对应行。左边是你遇到的现象,右边是该做的事。
| 你看到的 | 多半是什么原因 | 怎么办 |
|---|---|---|
| 框的位置整体偏移,但形状是对的 | 填充值与转换/校准侧不一致,或反换算时少减了 pad | 查 padding:部署侧保持 pad_color: [0,0,0],转换侧 quant_img_RGB2BGR=False |
| 框的位置对,但类别全错、分数都很低 | 颜色通道反了 —— BGR 喂给了要 RGB 的模型 | 确认 to_rgb() 被调用;转换侧不要开 RGB2BGR |
报 need 4dims input | 静态 shape 模型要 4 维 NHWC,你给了 3 维 | 用 np.newaxis 补成 (1,H,W,3)。跑 app.py 不会遇到,手写推理才会 |
报 core mode not supported | core_mask 传了 None | 显式传 core_mask=0(自动选核);2.3.2 上传 None 会直接报错 |
浏览器打不开 :8080/defect.mjpg | 端口被别的实验占了(实验 1~7 共用 8080) | 先关掉占用 8080 的进程;IP 用板子的局域网地址,不是 127.0.0.1 |
--ros 跑起来一直黑屏 | 相机驱动没起,或两个终端的 ROS_DOMAIN_ID 不一样 | 先起相机;两个终端写同一个 N;话题不要 remap |
| 程序不动,SSH 里像死机了 | --image 模式没加 --save,程序开窗等你按 q | 带 --save out1.jpg;已经卡住的按 Ctrl+C 退出 |
远程一行命令报 python: command not found | 非交互 shell 不读 .bashrc,ros2_venv 没被激活 | 改用 bash -lc "…",或写全路径 /home/iflytek/ros2_venv/bin/python;交互式登录后敲命令不受影响 |
| 画面上出现一堆问号方块 | OpenCV 的 putText 不支持中文 | 窗口里的字统一用英文,这不是乱码 bug |
进阶与深读
基础三步跑通之后再看这里。做不完不影响成绩,做了有加分。
进阶 1 · 用 onnx 和 rknn 各评一次分,看量化掉了多少约 30 分钟
同一个模型有两种格式:.onnx 是浮点原版,准但慢;.rknn 是 int8 量化版,快但会掉一点精度。src/eval_map.py 的 --backend 参数可以在两者之间切换,跑两次就能量出「为了快牺牲了多少准」。
python src/eval_map.py --backend rknn --model models/defect_yolov8n_int8.rknn --data <NEU-DET 数据集目录>
python src/eval_map.py --backend onnx --model train/weights/best.onnx --data <NEU-DET 数据集目录>
随仓库交付的权重在 val 集上是 P=0.657 / R=0.706 / mAP50=0.732。超过 3% 掉点,先查校准集:是不是用了跟真实画面差太远的图、数量够不够(--calib-count 默认 200)。
这两个分数只能在「同一份权重、同一份数据、同一段评测代码」下互比。拿它去跟别人的模型比谁强没有意义 —— 不同数据集算出来的 mAP 不可比。
进阶 2 · 把检测结果变成质检报表约 40 分钟
在 src/app.py 的主循环里,把每帧的检测结果按类别累加,每隔一批帧打印一次统计:
scratches: 12 处
inclusion: 3 处
patches: 1 处
这就是产线上「缺陷统计 + 质检报告生成」的形态。做法是找到返回检测结果列表的那一行,在它后面加累加逻辑,别动别的地方。
再往前走一步:把 Detector.detect() 返回的框转成 ROS2 的检测消息发出去,机械臂分拣或报警灯就能直接接 —— 这是第 11、12 章要干的事。
进阶 3 · 想自己训练一个模型约 3 小时,需要 PC 加显卡
完整链路是:准备数据集 → PC 上训练 → 导出 ONNX → 转成 RKNN → 拷到板子上跑。四个入口都在仓库里:scripts/train.sh、scripts/export_onnx.sh、src/convert_rknn.py、src/eval_map.py。
三个硬性前提,缺一不可:
- 必须用仓库里那个改过的 ultralytics(RKNN 优化 fork,
format='rknn')。官方版导出的 ONNX 不是 9 输出,转到 RKNN 就解不出来。 - 标注必须是 YOLO 归一化格式(
类别 cx cy w h,全是 0~1 之间的小数)。写成像素坐标训练「能跑完」,但 mAP 会趋近 0 —— 这种失败最难查,因为它不报错。 - 量化校准图要用 val 集、贴近真实产线画面,格式 jpg/png/bmp、绝对路径、不带中文。
这次的模型已经交付在 models/ 里,不重训也能完成全部实验内容。
代码复盘:让 AI 带你把这套代码读明白
这一节不逐行讲代码。给你三组提示词,由你自己指挥 AI 产出三张图,再拿真源码去对 —— 图对不对,反过来证明你读没读懂。
🧪 Vibe Coding · 自己把这段代码读明白约 20 分钟
你要产出三样:模块职责表 → 控制流流程图 → 时序图。提示词已给全,直接复制去问 AI。
下面三个块是给 AI 的提示词,不是终端命令 —— 复制到对话框里用。
提示词 1 · 模块职责分析
请阅读这几个文件:src/app.py、src/infer.py、src/preprocess.py、
src/postprocess.py、src/ros2_source.py、config/defect_config.yaml。
这是一个基于 RKNN 的 YOLOv8 工业缺陷检测项目。
请输出一张模块职责表,回答三个问题:
1)每个文件负责哪一件事,用一句话说清;
2)谁调用谁,从入口 src/app.py 往下画出调用关系;
3)每个可调参数(imgsz、score_thr、iou_thr、pad_color)
   分别由哪个函数读取。
输出格式:markdown 表格,四列是「模块 / 职责一句话 / 被谁调用 /
关键函数」,每条职责后面用 文件名:行号 标注出处。
提示词 2 · 控制流流程图
请为 src/app.py 的主循环画一张控制流流程图,按「处理一帧」为单位描述。
要求:
1)入口是拿到一帧,出口是画完框并输出(存盘 / 推流 / 显示);
2)必须画出所有判断分支,包括读帧失败、以及没有检测到任何目标;
3)每个框里写真实函数名(letterbox、to_rgb、inference、
   dfl_decode、classwise_nms、unletterbox、draw),
   不要写「预处理模块」这类空词;
4)用 mermaid 的 flowchart 语法输出。
提示词 3 · 时序图
请为「ROS2 相机实时检测」这条链路画一张时序图,参与者包括:
相机驱动节点、Ros2Camera(订阅者)、Detector、
RKNNLite(NPU)、MjpegServer。
要求:
1)按时间顺序列出至少 5 次交互,从相机发布图像开始,
   到浏览器拿到一帧结束;
2)标出真实话题名与回调函数名(_on_image、read、detect、inference);
3)标出单帧耗时或频率的量级(板端约 13 FPS,单帧约 77 毫秒);
4)用 mermaid 的 sequenceDiagram 语法输出。
自查三问:模块表里每一条都能指到真实的 文件:行号?流程图有分支、有退出条件?时序图里的参与者是真实的类名与话题名,而不是「用户 / 系统」这种空词?
再拿 AI 的版本和真源码对一遍,下面这五处差异几乎是必然出现的 —— 差异处就是设计决策:
| 差异点 | AI 版常见写法 | 工程版(本仓) | 为什么工程这样写 |
|---|---|---|---|
| 填充值 | pad=114(ultralytics 训练默认) | pad_color: [0,0,0](config/defect_config.yaml → letterbox()) | 填充值会参与卷积计算,必须与量化、校准时的取值一致,否则边缘特征偏移、框整体错位 |
| 归一化 | 代码里写 img / 255.0 | 不除。归一化交给 rknn.config(mean_values=0, std_values=255)(src/convert_rknn.py) | 量化模型内部已含 scale,Python 侧再除一次会把输入压到 0~1,分数整体塌陷 |
| NMS 放在哪 | 直接 model.predict(),后处理在库里 | DFL 解码与逐类 NMS 全在 src/postprocess.py,模型只出 9 个原始张量 | RKNN 转换器对动态索引、切片拼合支持差,后处理留在 CPU 更稳 |
| 通道顺序 | cv2.imread 读完直接喂 | 显式 to_rgb()(src/preprocess.py)+ 转换侧 quant_img_RGB2BGR=False | 两侧约定必须一致;不一致的症状是「框准、认错」 |
| NPU 初始化 | init_runtime() 不传参 | init_runtime(core_mask=0)(src/infer.py) | 2.3.2 上 core_mask 传 None 直接报 core mode not supported |
最后一个动作:改一处、先预测再验证。把 score_thr 从 0.25 改成 0.60,先在纸上写下你认为会发生什么,再跑一次对答案。猜错了最有价值 —— 那说明你对第 04 节步骤 3 的理解还差一层。
06互动:拖 score_thr,看漏检误检怎么拉扯
📌 这一节是「掌握检查」:亲手改一个参数,看现象是否朝你预期的方向变,还要能说出为什么 —— 说得出,才算掌握。
不改代码,只改两个数字,就能亲手感受「漏检」和「误检」是怎么互相拉扯的。先看它们在哪 —— config/defect_config.yaml 的 infer 段,下面是配置内容,不用执行:
infer:
  imgsz: 640
  score_thr: 0.25
  iou_thr: 0.45
  pad_color: [0, 0, 0]
改完保存,重跑一次 python src/app.py --model models/defect_yolov8n_int8.rknn --image images/1.jpg --save out1.jpg 就能看到变化。下面这个实验台把同一帧的七种情况摆在一起,你先在页面上拖一遍,再去板子上验证。
两种改法,后果正好相反:
| 改成什么 | 你会看到 | 什么时候该这么改 |
|---|---|---|
score_thr: 0.05往低调 | 框变多。漏掉的弱小缺陷被抓回来,但同时冒出一堆假框 | 质检要求「一条都不能漏」的时候。宁可多报,让人工复核 |
score_thr: 0.60往高调 | 框变少。留下的都很确定,但细小的划痕消失了 | 误报太多、产线老是误停线的时候。宁可少报,也得报得准 |
iou_thr: 0.30往低调 | 去重更狠:那一对重叠的 patches 框被合成一个,但挨得近的两处真缺陷也可能一起被合掉 | 一般不用动。0.45 是工程上试出来的默认值 |
你刚才发现的:漏检和误检的代价是反着来的 —— 一个降下去,另一个就升上来。这叫召回和精确的权衡,任何检测器都躲不开。
所以在产线上真正要问的不是「哪个参数最好」,而是:漏掉一个缺陷和误报一个缺陷,哪个代价更大?想清楚这个,参数就定了。
score_thr 管漏多少,iou_thr 管合多少,两者都得对着产线的代价表来定,而不是对着截图调到好看。07验证:四道小测
回页首对照「🎯 实验目标」逐类自检 —— 四类都要对上题,缺一项就回对应小节补完再交卷:
| 目标类别 | 页首那一条说的是 | 对应题 |
|---|---|---|
| 原理 | 说出四步各在干什么、两个阈值各卡在哪一步 | Q2 |
| 实践 | 跑通两条链路,读出「类别 + 分数 + 坐标」三件套 | Q1 |
| 应用 | 说清接在产线哪一环、阈值按什么代价定 | Q4 |
| 重难点 | 框歪了不一定是模型的错(形对位漂先查换算) | Q2 |
另外 Q3 考的是边界:这套模型什么时候不管用。四题全 ✓,这一章就完成了。
score_thr 从 0.25 调到 0.70,最可能发生什么?score_thr 是「及格线」,调高等于要求模型更有把握才敢报。代价是信心不足的弱小缺陷被整批过滤掉,漏检上升。框位置偏移跟这个参数无关 —— 那是补边量与反换算的事。pad 前后对不上,或反换算时忘了减它(坐标 − pad) ÷ scale 换回原图。忘了减 pad,所有框会朝同一方向偏同样的距离 —— 系统性偏移,一看就露馅。回看第 04 节步骤 4 那道 1600×200 的算例。score_thr 往上调 —— 宁可少报,也别让假框把线停了iou_thr 往上调 —— 让去重更宽松,多留下一些框imgsz 调大 —— 图更清楚,误报自然就少了score_thr 往上调。代价是漏检上升 —— 但这正是「阈值按代价选」:这条线最怕停线,那就接受偶尔漏报,让下游人工复核兜住。iou_thr 管的是同一处缺陷报几次,不管真假;imgsz 是输入尺寸,跟误报没有直接关系。反过来,如果这条线「一条都不能漏」,就该往低调、配人工复核 —— 两个方向的代价,你得先问清楚产线怕哪一个。08章节总结:缩进去、算一遍、挑最像的、缩回来
这页讲了什么,它们怎么串起来
| 概念 | 它解决了什么 | 和别的关系 |
|---|---|---|
归一化标注cls cx cy w h | 把「人画的框」变成机器能读的数字;用 0~1 比例表示,换输入尺寸不用重算 | 整条链的最上游 —— 没有标注就没有模型;格式错了训练直接崩,后面全部白做 |
| 训练 yolov8n / 640 / 100 epoch | 让网络从标注里长出判断力,而不是靠人写规则 | 吃标注,吐 best.pt;参数里的 imgsz 必须与推理侧 infer.imgsz 一致 |
| int8 量化 + 校准集 | 把 32 位浮点压成 1 字节,体积带宽降到约 1/4,才跑得出 13 FPS | 吃 best.pt → ONNX → .rknn;校准集不准 → 掉点超标;判据是 mAP50 掉 ≤3% |
| mAP50 / PR 曲线 / 混淆矩阵 | 回答「这个模型到底行不行」;也能解释某类为什么分数低(crazing AP 0.408) | 量化前后各评一次,差值就是量化损失;指标必须连着「哪份权重、哪份数据」一起说 |
| letterbox 等比缩放 + 补边 | 模型只吃 640 的方图,而照片任意尺寸;直接拉伸会把细长的划痕压扁,形状一变网络就不认 | 上游是原图;下游所有框坐标都活在 640 坐标系里,必须由它再换回来 |
| RGB 顺序 + 不归一化 | 让 Python 侧的输入与量化模型内部的 scale 对齐 | 由转换侧 quant_img_RGB2BGR=False、std_values=255 定死;弄反了就是「框准、认错」或「分数塌陷」 |
| 9 个原始张量 + DFL | 80×80 抓麻点、40×40 中等、20×20 抓大片斑块;16 bin 概率加权让边界模糊的目标也稳 | 吃 640 的 RGB 张量;吐出几千个候选框,交给筛分与 NMS |
| score_thr 置信度阈值 | 先粗暴卡一刀,把不可能的都丢掉 | 在 NMS 之前;和 EXP-01 的 HSV 色彩范围本质是同一件事 —— 多少算通过 |
| IoU + 逐类 NMS | 同一处缺陷被圈十几次,按分数排队、留最高的、删重叠的同类框 | 吃筛分后的框;iou_thr 调到 0.30 会误删挨得近的两处真缺陷 |
| unletterbox (坐标 − pad) ÷ scale | 把 640 图上的坐标换回原图,框才贴得住缺陷外沿 | 是 letterbox 的逆运算;单一地漏减 pad,就是系统性平移 |
| draw 画框(不是模型干的) | 检测器只吐「类别 + 分数 + 四个数」,红框是后面代码画的 | 所以「框错了」有两种可能:模型算错,或我们画的时候换错 —— 先分清这个 |
② 直觉是缩到 640 就是把图拉成 640×640,实际是等比缩放再补边,因为网络学的是「这个形状像划痕」,一拉扁形状就变了,它反而认不出。
③ 直觉是阈值调高更保险、报的都是真的,实际是
score_thr 一高,信心不足的细小划痕直接被滤掉 —— 漏检和误检的代价反着走,产线上要问的不是「哪个值最好」,而是「漏一个和误报一个,哪个更贵」。
score_thr: 0.25 是 0~1 的分数不是 25%;imgsz: 640 是输入的边长不是面积;pad 的单位是像素,在 640 图上算、往原图上减 —— 三个量的单位混了,偏移就会莫名其妙。② 填充值
pad_color 在转换、校准、推理三处必须是同一个数;实验 1~7 共用 8080 端口,不能同时跑;iou_thr 调到 0.30 会把挨得近的两处真缺陷合成一个。③ onnx 与 rknn 的 mAP50 差要 ≤ 3% 才算量化合格,而这两个分数只能在同一份权重、同一份数据下互比;单图模式必须带
--save,否则 SSH 里就是「假死」。
前置依赖 · 缺一样就跑不起来
| 类型 | 具体项 | 缺了会怎样 / 怎么补 |
|---|---|---|
| 环境 | 实时模式要 ROS2:source /opt/ros/humble/setup.bash + source ~/ros2_ws/install/setup.bash + export ROS_DOMAIN_ID=N,两个终端都要重来一遍 | 只 source 第一个 → 找不到 ascamera 包;两个终端 N 不一致 → 互相看不见,--ros 一直等首帧 |
| Python 库 | 板载 ros2_venv 里的 rknnlite 2.3.2、onnxruntime、OpenCV、NumPy、PyYAML | 缺 rknnlite → .rknn 直接加载失败;缺 onnxruntime → 换后端那条命令跑不起来 |
| 模型 / 资源 | models/defect_yolov8n_int8.rknn(int8 单核 + 剪枝,200 张 val 校准);train/weights/best.onnx(9 输出,换后端对比用);测试图 images/1.jpg~4.jpg | 看不到这些,说明目录不对或文件没拷全。板上不需要 NEU-DET 数据集 —— app.py 内置了 6 类名兜底,看到 note: 那行属正常 |
| 配置 | config/defect_config.yaml 的 infer 段:imgsz: 640、score_thr: 0.25、iou_thr: 0.45、pad_color: [0,0,0] | 缺键 → 加载时直接抛 ConfigError(契约式校验);imgsz 与训练的 640 不一致 → 框全乱且不报错 |
| 硬件 / 前置实验 | 6TOPS NPU 才有约 13 FPS;实时模式要板载 HP60C 相机 + ros2 launch ascamera hp60c.launch.py;前置 EXP-01~03 的「阈值思维」 | 没相机 → 只能跑单图/视频,--ros 无输入;没读前三章也能跑通,但会少了「多少分算通过」这个直觉 |
这套代码用在哪儿
- 钢材质检工位:产线相机逐帧送进去,每条结果给「类别 + 置信度 + 左上右下坐标」,质检员照着复核。
score_thr按代价定:要「一条都不能漏」就用低阈值配人工复核,误报多到停线就调高。 - 缺陷统计与质检报表:在主循环里按类别累加,周期性打印
scratches: 12 处 / inclusion: 3 处,直接生成班次报表 —— 这是产线上真正在跑的形态。 - 分拣与报警联动:把检测框转成 ROS2 检测消息发出去,机械臂按类别分拣、或点亮报警灯。第 11、12 章的体感控制会用到同一套「视觉输出喂给控制」的模式。
- 换场景就是换权重:它对桌面、对手只会硬套(域偏移)。想用在别的产线,得走完「数据集 → PC 训练 → 导出 ONNX → 转 RKNN」四步 —— 三个入口脚本都在仓库里。
下一章换个角度:如果模型认出的东西太细(矿泉水瓶、香蕉皮、废电池),而垃圾桶只分四类,中间这层「翻译」谁来做?